JetBrains 开源 12B 编程智能体模型 Mellum 2.1,吞吐近翻倍
JetBrains 于 10 月 8 日发布 Mellum 2.1,这是该公司继 6 月开源后的第二代 12B 参数混合专家(MoE)编程智能体模型,仍以 Apache 2.0 许可开放,每次推理仅激活 2.5B 参数。它面向在自有硬件上运行的编程智能体与子智能体场景,目标是在不牺牲速度的前提下,让小模型也能真正在仓库里干活。
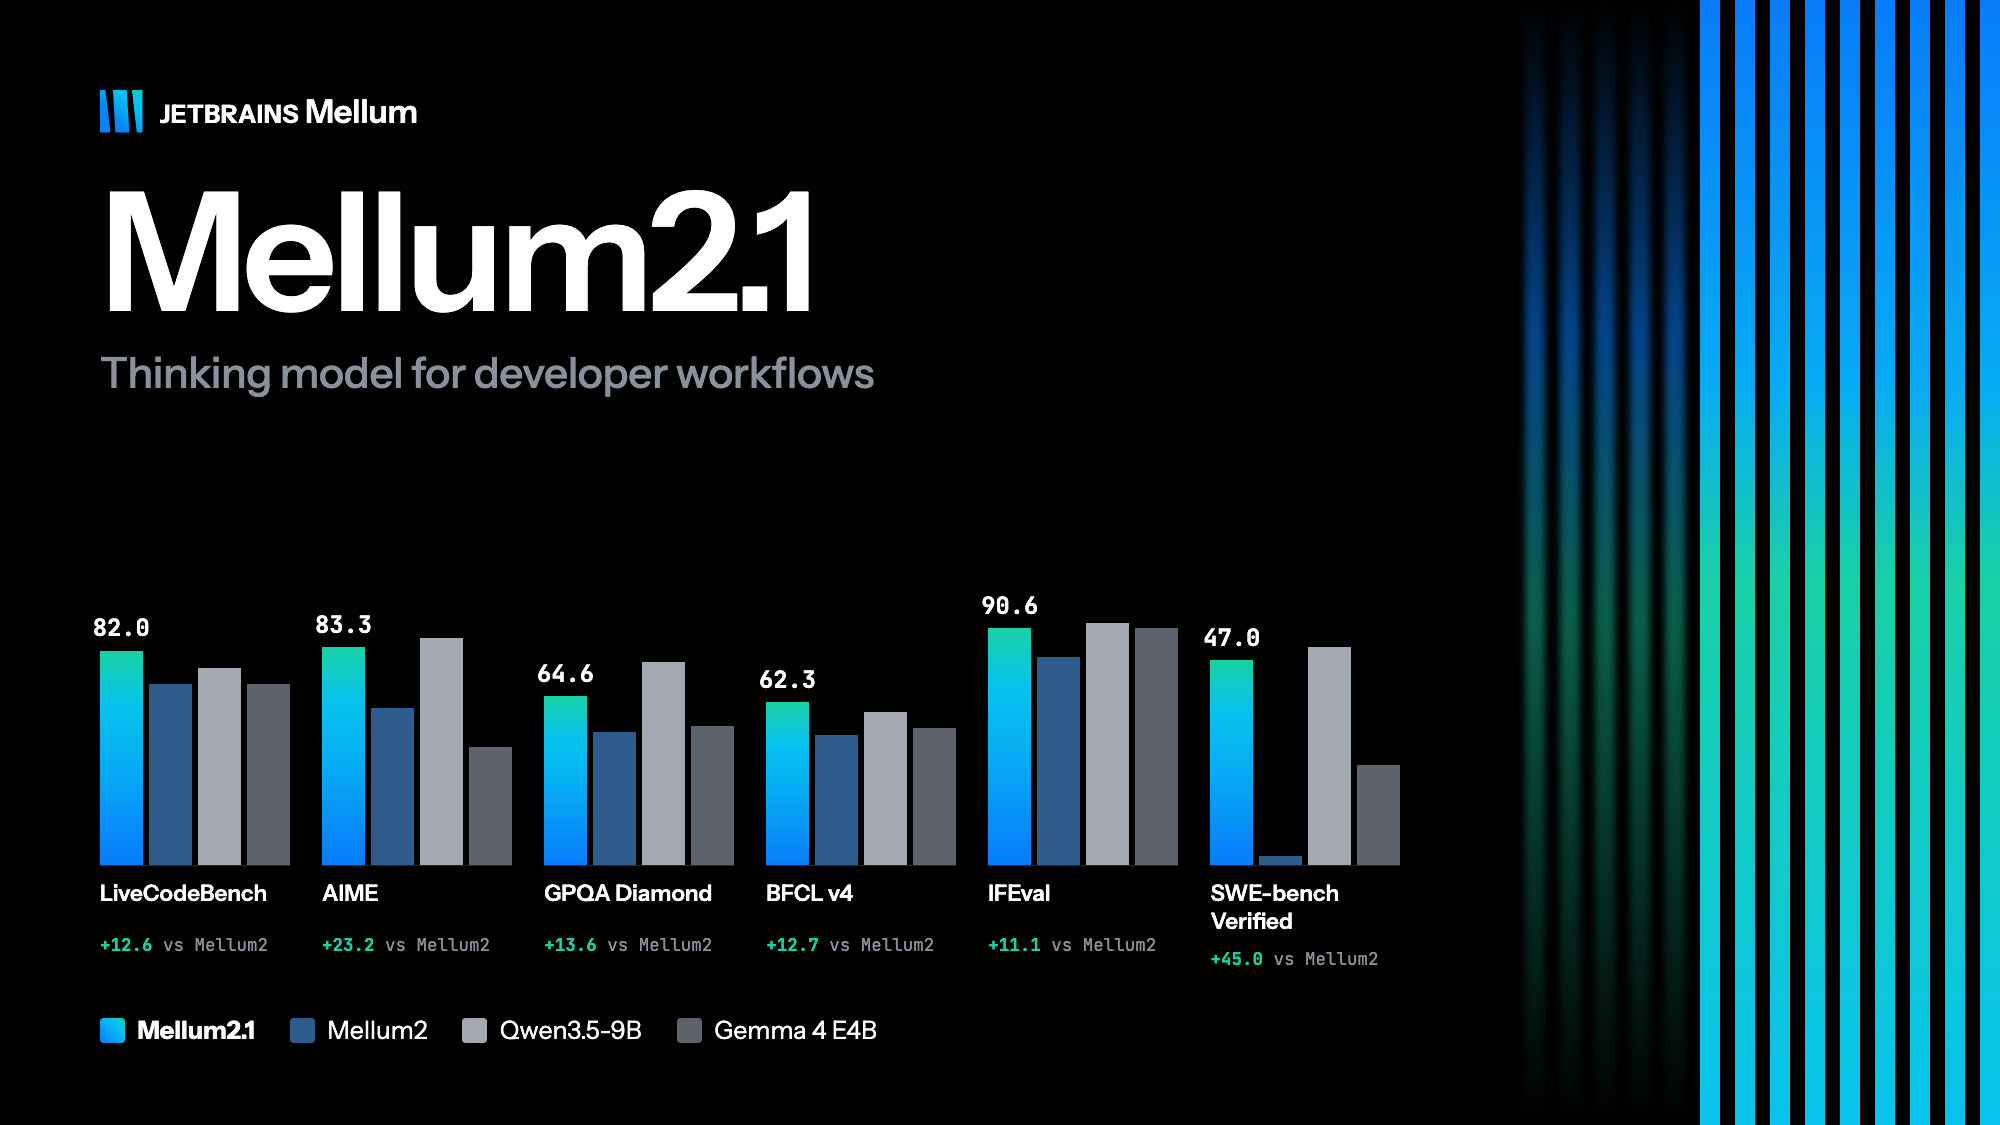
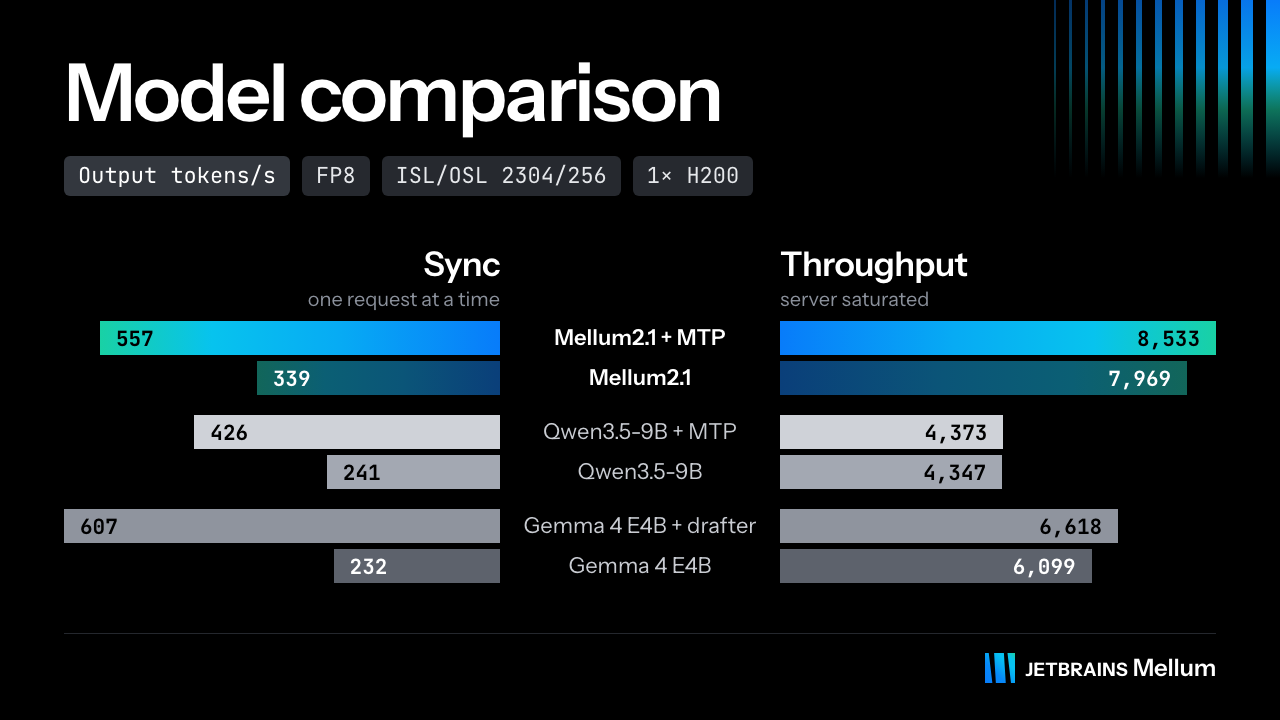
与上一代相比,Mellum 2.1 架构未变,变化几乎全部发生在预训练之后。团队用一个夏天在真实环境中做强化学习,跨数千个环境发起了数百万次沙箱运行,让模型学会探索代码库、修改文件并自检改动。效果最明显的是智能体编程:在 SWE-bench Verified 真实 GitHub bug 修复上,它从 Mellum 2 的 2% 跃升到 47%;在 LiveCodeBench v6 编程谜题上达 82%,在 BFCL v4 工具调用上达 62.3%。多词元预测(MTP)让单条请求再快约 1.6 倍。
速度是其核心卖点。JetBrains 称,在高负载下单张 H200 上 Mellum 2.1 的推理吞吐接近 Qwen3.5-9B 的两倍。在真实代码库的长任务上,Qwen3.5-9B 仍以 50% 略胜其 47%,但 Mellum 2.1 在编程谜题与工具调用上领先,定位更偏大量子智能体跑在固定 GPU 预算上的常规工作。
部署上,Mellum 2.1 现已登陆 Hugging Face,可用 vLLM 直接加载;面向 llama.cpp、Ollama、LM Studio 的 GGUF 构建以及 vLLM 的 MTP 投机解码头随后放出。由于可本地或自有基础设施运行,企业的代码与数据始终留在自己环境内,这一点对金融、医疗等合规敏感行业尤为关键。
放到更大背景看,Mellum 2.1 体现了开源小模型的一条现实路径:不靠堆参数,而靠真实仓库中的强化学习与生成—验证—精炼式推理循环补齐能力。在同档开源模型中,它与 Qwen3.5-9B、Gemma 4 E4B 正面竞争,也呼应了业界把大模型能力稳定、廉价地投射到长流程任务的整体趋势。
读者评论 (0)
想参与讨论?请 登录 后发表评论。
还没有评论,欢迎抢沙发!