清华OSWorld-Science基准:AI操作科研软件平均得分仅34.3%
由清华大学团队牵头,联合加州大学洛杉矶分校、耶鲁大学、卡内基梅隆大学、加州大学伯克利分校、斯坦福大学、浙江大学、香港大学、东京大学等机构的研究者共同推出的 OSWorld-Science 近日正式亮相。这是一个面向真实科研场景的计算机使用智能体评测基准及配套基础设施,并获得 Kimi、Z.ai、阿里巴巴等公司基础模型部门的支持。
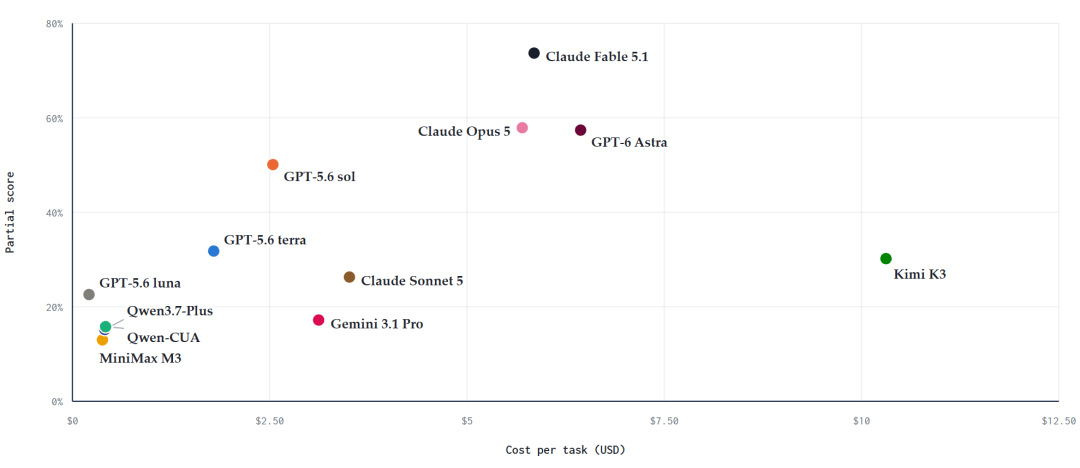
该基准包含 146 项专家设计的任务,覆盖 7 大科学领域、14 种科研软件配置,首轮共测评 12 个视觉语言模型,平均任务得分仅 34.3%。任务设计贴近真实研究流程:在 Mnova 中完成核磁共振分析、在 SAS 中开展统计计算、在 QuPath 中处理病理图像、在 ANSYS 中进行物理仿真。智能体需在虚拟机中通过键鼠或终端操作软件,每一步行动后根据新的界面状态决定下一步,最终评分依据是任务结束后的文件产物与应用状态——模型自称完成了什么,还要由实际结果来证明。
结果呈现出明显的能力边界。Claude Fable 5.1 以 73.7% 的平均任务得分领先,Claude Opus 5、GPT-6 Astra 和 GPT-5.6 sol 的得分分别为 57.9%、57.4% 和 50.1%。分学科看,统计任务中各模型普遍表现较好,但化学任务里只有 Claude Fable 5.1 与 Claude Opus 5 能够超过 20%;GPT-6 Astra 在医学影像任务中得分率达 69%,在化学任务中却表现不佳。评测同时显示,得分最高的模型并非成本最高的模型,性能与调用成本之间并非简单的线性关系。
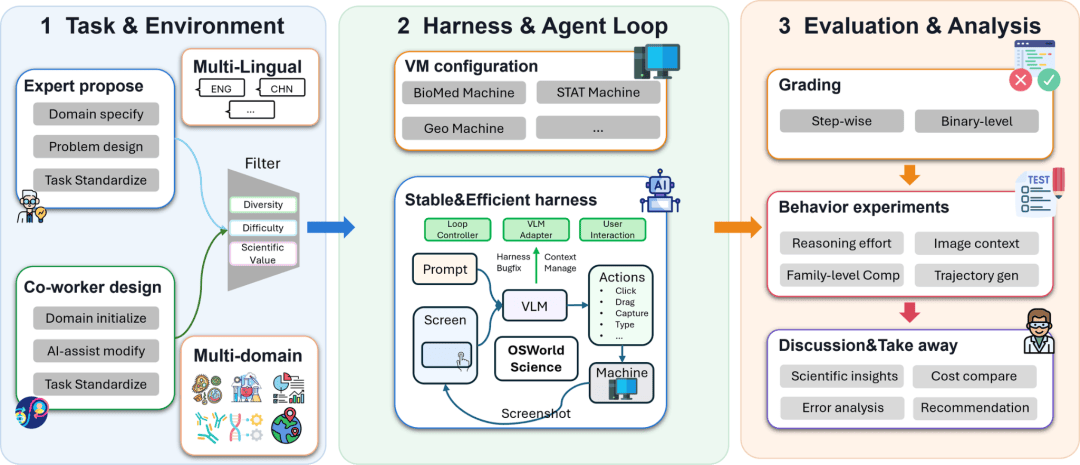
失败模式同样具体。在 Mnova 的一次运行中,Claude Sonnet 5 因坐标映射偏差,在同一个错误位置重复点击了 39 次,最终耗尽预算而任务失败。团队对已公开轨迹的分析显示,61% 的失败运行没有留下可评分产物,同时耗尽了步骤或时间预算。而在 ANSYS Fluent 的圆柱绕流伴随任务中,Kimi K3 发现阻力读数为零后,主动重新检查设置、修正漏选壁面的问题,最终获得满分。研究也提醒,如果检查始终围绕同一个错误表示展开,一致的结果可能只是同一个错误被保留了下来,科学验证需要独立的证据。
研究团队表示,后续计划补充无机化学、生命科学、力学、材料学、地球科学、社会科学等方向的真实问题,并设计更全面的跨软件工作流,例如在 PyMOL 中打开蛋白质结构、定位目标结合口袋并完成关键残基测量,随后导入 AutoDock Vina 进行小分子对接,再将结果导回 PyMOL 可视化。目前任务与数据集、项目代码已分别在 HuggingFace 与 GitHub 开放,任务共建问卷同步上线。
读者评论 (1)
想参与讨论?请 登录 后发表评论。
34%的分数其实挺打脸,看来大模型在科研里还得靠人盯着,不然就是瞎按