Reflection发布5010亿参数开源模型Beam,传英伟达洽谈收购
10月5日,美国AI创业公司Reflection AI发布首个开放权重模型Beam。这家2024年由前谷歌DeepMind研究人员Misha Laskin和Ioannis Antonoglou创立的公司,将Beam定位为面向企业、公共部门和开发者的“主力模型”,主打编程、推理和智能体任务。
据官方博客介绍,Beam采用稀疏混合专家(MoE)架构,总参数量达5010亿,每个token仅激活230亿参数;预训练数据为23.8万亿条精选token,官方资料显示其有效上下文长度可达100万token。其能力来自大规模强化学习:官方称在约1.05万块英伟达GB300 GPU上完成了为期4周的训练,生成超过1亿次rollout。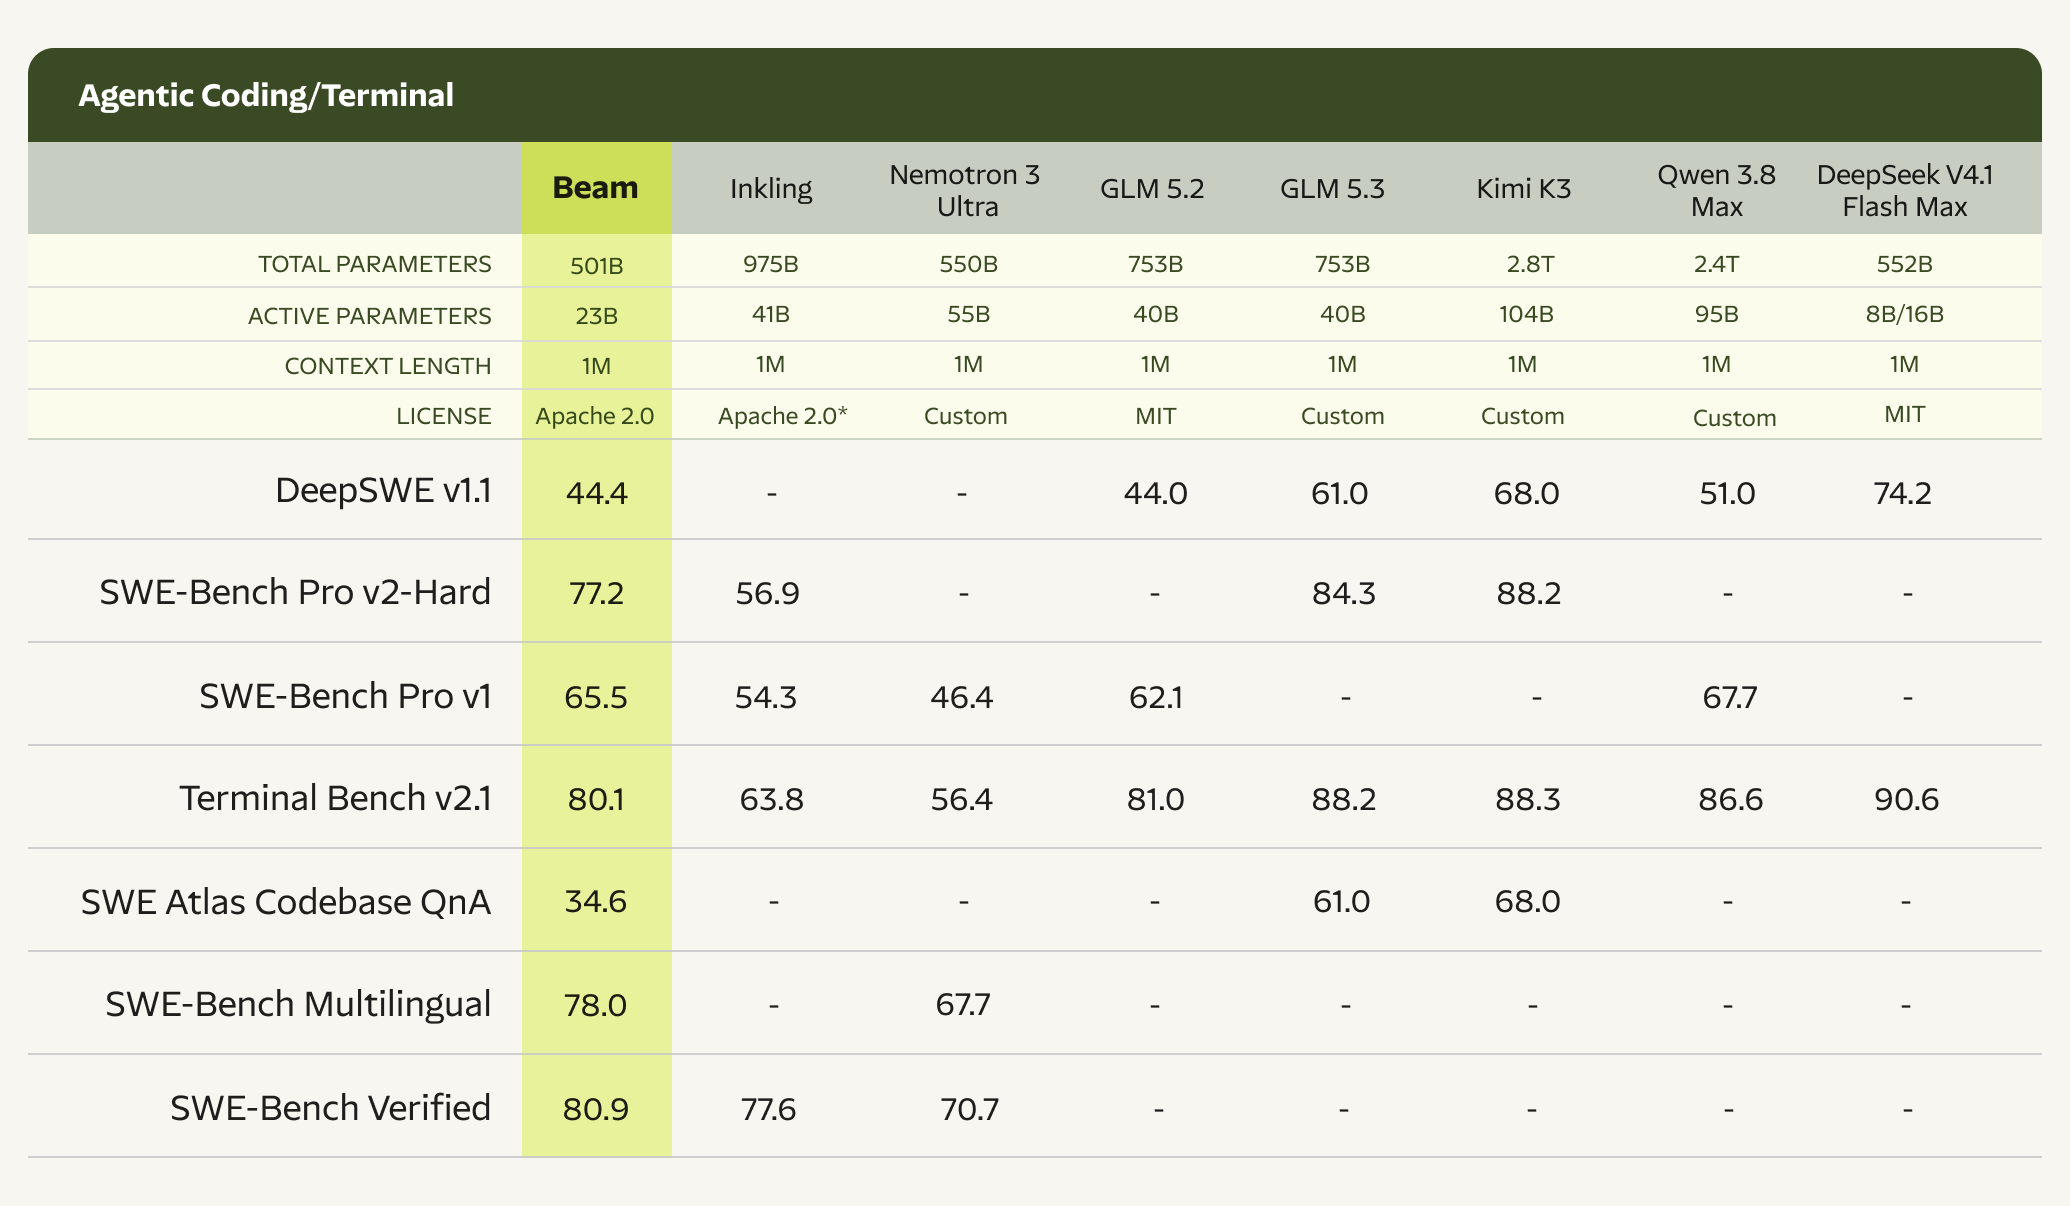
Reflection表示,在高级推理基准上Beam的成绩与智谱GLM-5.2相当,而所需推理算力只有后者的三分之一到四分之一;面对参数规模在2万亿以上的Qwen 3.8-Max,效率优势更加明显。不过从官方公布的跑分看,Beam与GLM-5.3、Kimi K3等中国顶尖开放模型仍有差距,其卖点是“每token智能”而非绝对分数。官方计划本月内放出权重、技术报告和模型卡,目前开放早期访问申请。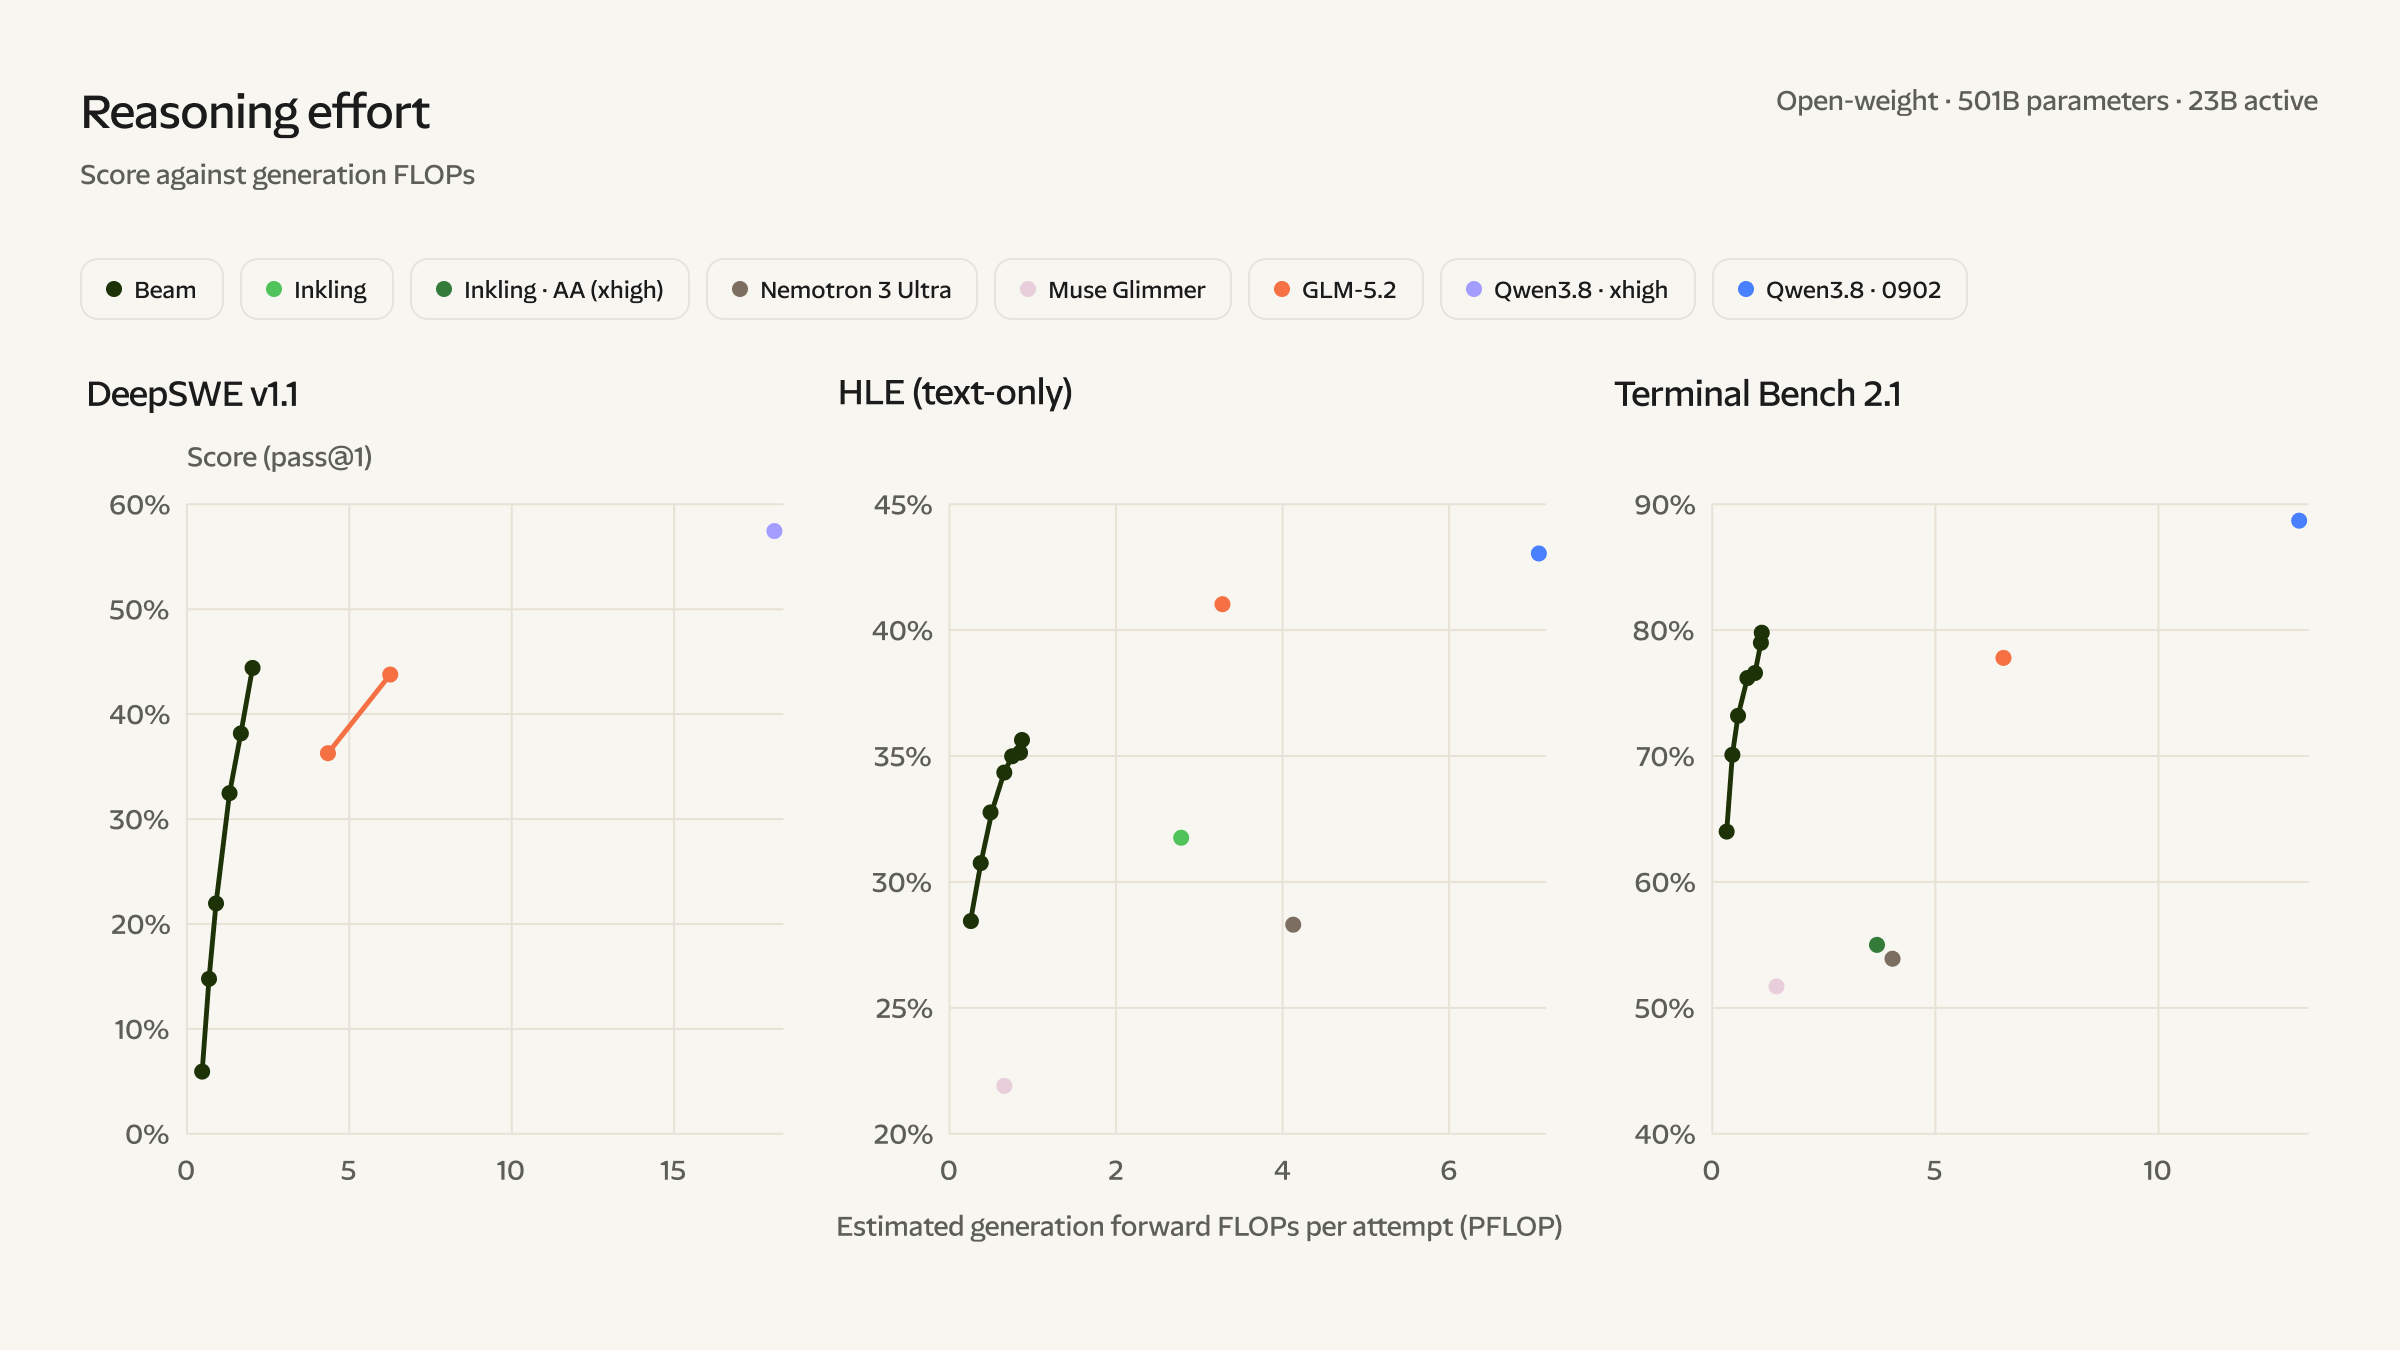
真正让业界关注的是资本动向。据《金融时报》报道,Beam发布数日后,英伟达正洽谈对Reflection进一步投资或直接收购,方案也包括“聘用团队+技术授权”的变通形式。英伟达已是Reflection的重要投资方,若交易达成,其芯片业务将与模型层绑定更深。谈判尚处早期阶段,尚未达成协议,双方也未公开回应。
背景上,美国在开放权重模型领域已明显落后于中国——Meta的LLaMA系列停更后,西方阵营长期缺少有竞争力的开源模型底座,Reflection因此被称作“美国版DeepSeek”。该公司累计融资约47亿美元,估值250亿美元;CEO Laskin公开称中国开放模型是给全球开发者的“礼物”,并称团队正是因为找不到合适的西方开放底座,才决定自研预训练。
读者评论 (0)
想参与讨论?请 登录 后发表评论。
还没有评论,欢迎抢沙发!