谷歌新旗舰Gemini 4 Argon发布 ARC-AGI-3得分97.5%逼近GPT-6
谷歌DeepMind于10月16日发布新一代前沿大模型Gemini 4 Argon。在被视为通用问题求解最难基准的ARC-AGI-3上,Argon取得97.5%的成绩,成为继OpenAI之后第二家跨过95%门槛的AI实验室,仅次于GPT-6 Astra的99.9%。
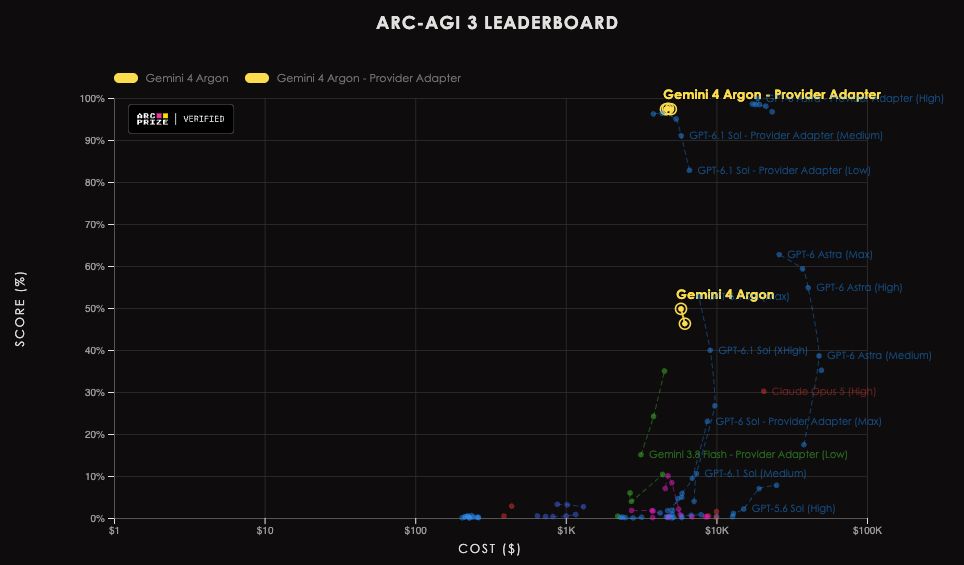
根据ARC Prize的测试结果,Argon在25个公开关卡上比人类基线少用了62%的操作步数,与GPT-6 Astra表现接近,并在其中3关追平或刷新速通纪录。在更早版本的基准上,Argon同样亮眼:ARC-AGI-2得分91.3%,ARC-AGI-1得分98.5%。研究机构Epoch AI给出的综合能力指数(ECI)为165分,落后于Opus 5.5的167分和GPT-6 Astra的166分,但明显领先于上一代Gemini 3.8 Flash的157分,是谷歌自今年2月Gemini 3.1 Pro以来最接近AI前沿的一次。
不过Argon并非全面领先。Epoch AI的细分评估显示,它在知识与视觉、智能体等基准上表现突出,但在数学能力指数上仅排第八,在软件工程指数上排第六,与榜首仍有差距。测试方式也显著影响分数:在仅允许回合间简单笔记的“标准环境”下,Argon在低推理档仅得49.8%,且在最高档因接口问题未能完成全部关卡,ARC Prize因此未公布该档分数。这延续了今年7月围绕基准测试环境公平性的争议——不同API设置会让同一模型的表现天差地别。
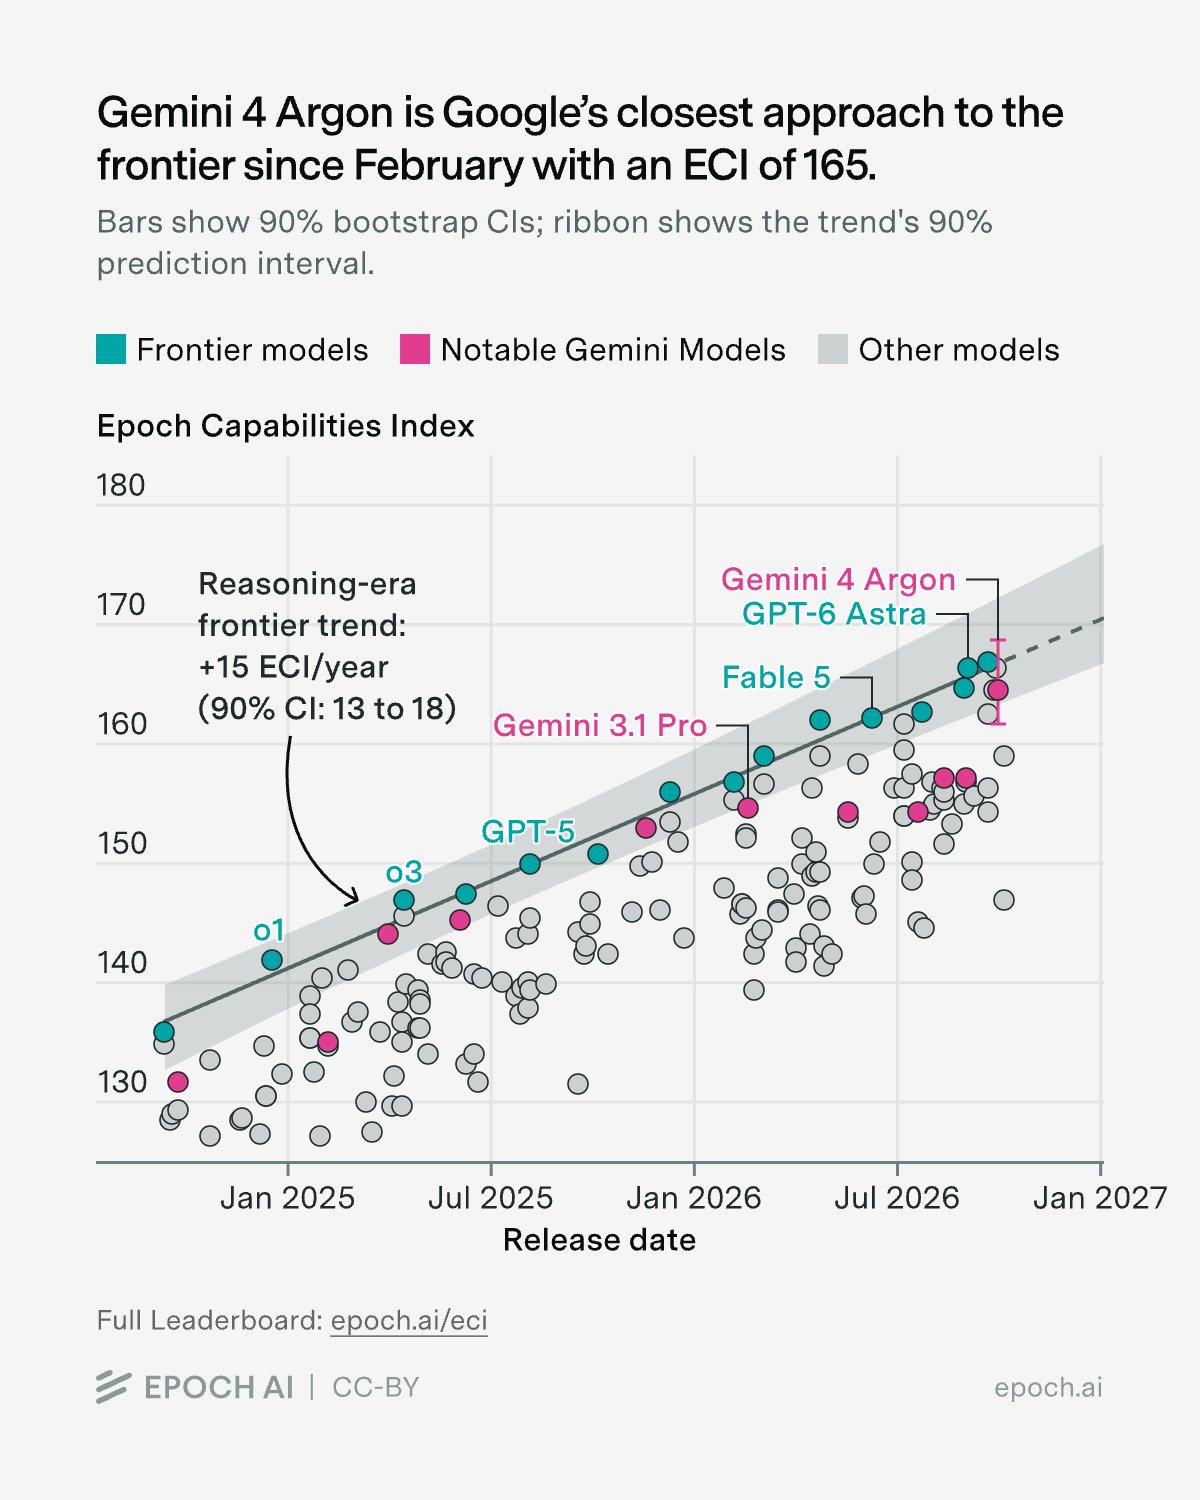
对谷歌而言,Argon的意义不只是又一款模型发布。过去一年,OpenAI、Anthropic在前沿模型上轮番领先,谷歌亟需一个能稳定进入第一梯队、并在长周期复杂任务中可依赖的旗舰。Argon在通用推理上的逼近,意味着谷歌在智能体、多模态与科研辅助等依赖强推理的场景里重新有了可打的牌。与此同时,模型能力的快速收敛也提醒行业:当多家实验室都能跨过95%这类里程碑,真正的竞争将转向成本、延迟、上下文管理与垂直场景的落地效率,而非单纯的榜单数字。
读者评论 (0)
想参与讨论?请 登录 后发表评论。
还没有评论,欢迎抢沙发!