DeepSeek开源V4.1 Flash 1017 编码成本降约六成
10月17日,深度求索(DeepSeek)将旗下V4.1 Flash模型更新至V4.1-Flash-1017版本,网页端、App与API已同步切换。此次更新被官方定义为一次“帕累托改进”——在性能提升的同时,推理延迟与调用成本同步下降,而非以牺牲一方换取另一方。
从公布的基准看,新版本在多个编程与智能体测试中刷新成绩:DeepSWE v1.1从74.2升至77.0,Terminal-Bench 4.0从31.2跃升至42.3,ProgramBench、Automation-Bench等亦有明显提升。支撑这一变化的是基于自反馈的强化学习,模型在训练中自行给出反馈,反复优化从需求到成品的端到端链路,并强化了视觉与多模态理解能力。
成本曲线的下移更为直观。在DeepSWE评测中,1017版以最高档完成单个任务的平均费用约为1.3元,而上一代最高档约需3.3元,降幅接近六成。结合MIT开源权重与FP8支持,该模型在开源阵营中对标Meta、Qwen、Mistral等同类产品,对闭源模型的定价形成压力。
与模型同步开放的,还有DeepSeek自研搜索引擎的Search与Fetch接口,按每千次成功请求5元计费,此前通过服务端工具调用的免费期将于11月1日结束。这意味着开发者可以为智能体接入检索与网页抓取能力,把“搜索—抓取—编码—执行”收拢到同一套可调用的基础设施中。
从影响看,一个Flash档位的轻量模型在多项Agent基准上逼近甚至局部超过旗舰模型,说明轻量模型与旗舰模型之间的能力边界正在模糊。对于需要数据主权、偏好自托管的团队,开源权重加低成本的组合正在成为生产环境的一线选项。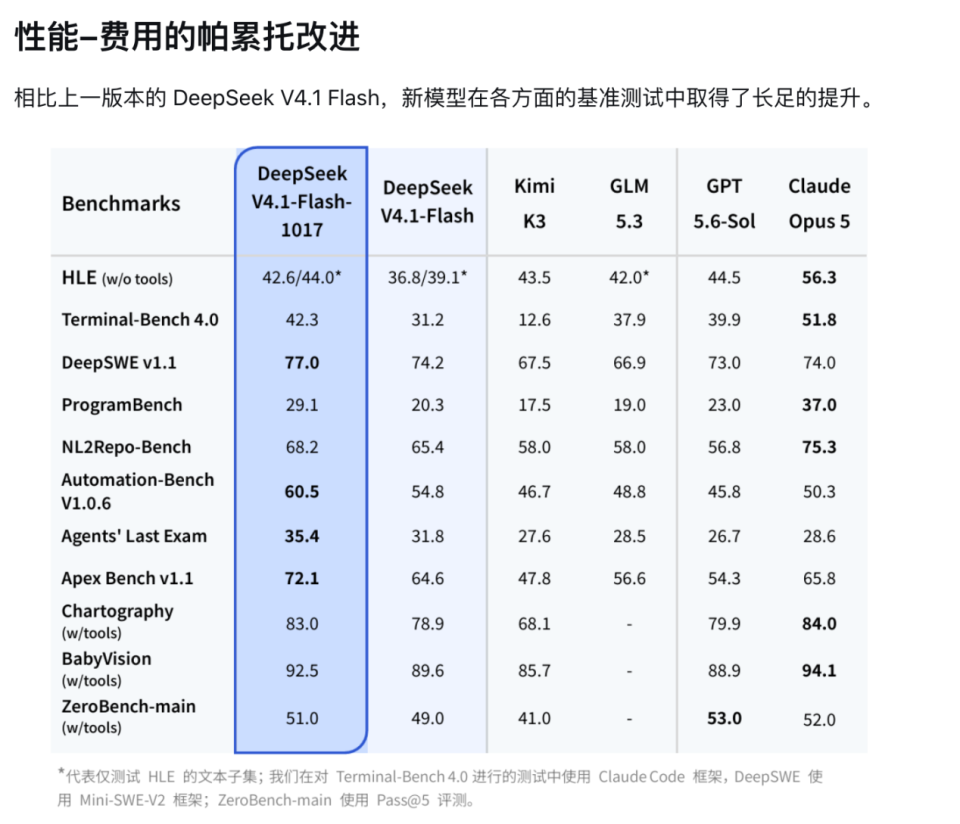
背景上,这已是DeepSeek在9月发布V4.1 Flash之后的又一次迭代。公司将竞争焦点从单纯的“模型分数”推向“任务交付链条”的系统性调优,并为自家的DeepSeek Harness及腾讯CodeBuddy、WorkBuddy等编程框架做了专项适配。
读者评论 (0)
想参与讨论?请 登录 后发表评论。
还没有评论,欢迎抢沙发!