德国 Aleph Alpha 发布 Kolibri 开放权重模型 主打欧洲主权 AI
德国 AI 公司 Aleph Alpha 发布 781 亿参数的开放权重语言模型 Kolibri,采用混合专家架构、每 token 仅约 34.6 亿参数激活,在欧盟境内训练并遵循《人工智能法案》,面向政府、航空与工业等敏感场景。
德国 AI 公司 Aleph Alpha 于 10 月初发布开放权重语言模型 Kolibri,主打“欧洲主权 AI”定位。模型参数规模 781 亿,采用混合专家(MoE)架构,每个 token 仅激活约 34.6 亿参数,兼顾德语与英语,权重以 Apache 2.0 许可发布在 Hugging Face,且不提供官方托管 API,用户需自行下载部署。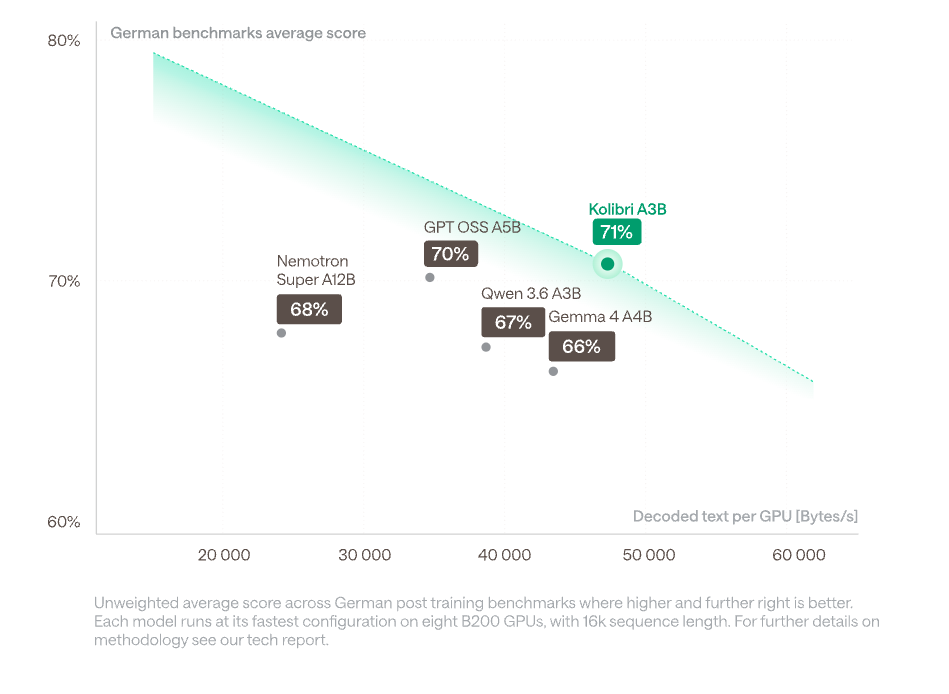
技术报告显示,Kolibri 从零训练于 20 万亿 token,德语占训练语料的 21.3%,并配有专门的德语数据管线;训练在位于德国与芬兰的 768 块英伟达 B200 GPU 上完成,公司强调模型在欧盟与德国法律下开发、不受外国控制。模型支持最长约 100 万 token 的上下文窗口,德语基准得分约 71%,解码速度快于 GPT OSS、Qwen 3.6 与 Gemma 4 等同级开放权重模型。
与多数闭源大模型不同,Kolibri 不靠订阅或 API 计费回收训练成本,收入来自部署、集成与支持服务。其卖点在于数据不出本地网络、无厂商端点经手,契合政府对敏感工作负载“数据主权”的要求。Aleph Alpha 还披露,训练数据中包含用中国模型生成的合成数据。
Kolibri 的目标客户是公共行政、航空与制造业——这些领域往往不愿把敏感数据送往海外云。欧盟《人工智能法案》的合规并非事后补丁,而是从设计之初就内嵌的约束,这使得采用方在履行数据溯源、风险管理与人工监督等义务时有了现成起点。它能否真正打动欧洲机构付费,仍要看独立基准与实际部署效果。模型 FP8 权重约 78GB,可装入单台高配节点,降低了中小机构自托管的门槛。
读者评论 (1)
想参与讨论?请 登录 后发表评论。
德语占比超两成还打主权牌,欧洲人连模型都怕被美国管住了。