Meta 推出 Muse Wonder 旗舰大模型,靠主动记忆与持续专注重回 AI 前沿
10 月 12 日,Meta 超级智能实验室发布新一代旗舰大模型 Muse Wonder 与 Muse Wonder Full。这是 Meta 重组 AI 团队 14 个月以来,首次宣称达到“前沿水平”的旗舰模型,被视为其摆脱 Llama 4 失利、重新回到第一梯队的关键一步。
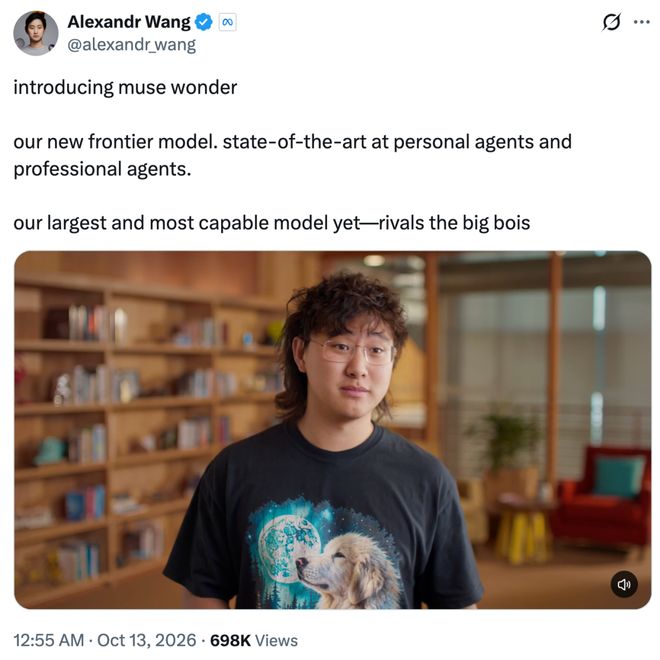
两款模型最突出的两项能力是“主动记忆”(Active Memory)与“持续专注”(Active Focus)。主动记忆让模型能够跨对话保留并调用与用户相关的重要背景信息;持续专注则使模型在面对复杂目标时持续推进,遇到障碍时主动尝试其他思路,并根据新信息调整方案。这些能力都指向扎克伯格提出的“个人超级智能”愿景——让 AI 真正理解个人目标与偏好。
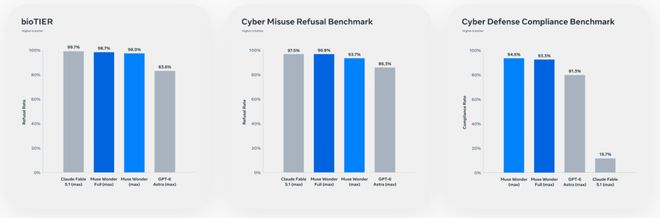
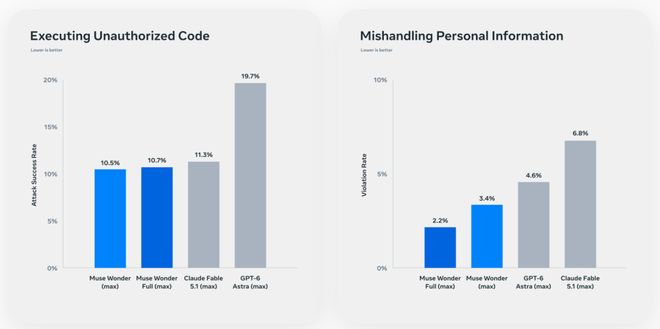
在基准表现上,Meta 公布的测试数据显示,Muse Wonder 在编程、长程任务与知识工作等多项评测中已达到或超过 Claude Opus 5.5、GPT-6 Astra 等头部模型。在其内部 MemoryBench 记忆评测中,Muse Wonder 得分 85.6,高于 GPT-6 Astra 的 81.4 与 Opus 5.5 的 81.5。不过,Meta 此次并未开放两款旗舰模型的权重,标准版 API 定价为每百万输入词元 4 美元、输出 20 美元,完整版 Wonder Full 仅面向 Muse Code 订阅用户开放。
发布后,Muse 个人 AI 智能体产品受到市场关注,曾登顶美国区 iOS 与安卓应用下载榜,并带动 Meta 股价走强。扎克伯格表示,公司将继续加大投入,模型迭代速度“可能会让人感觉明显加快”。
值得关注的是,在 Anthropic、OpenAI 等机构接连呼吁放缓前沿大模型开发的背景下,Meta 选择了不同的节奏。过去一年多,Meta 引入年仅 28 岁的 Alexandr Wang 出任首席 AI 官,并建成吉瓦级“普罗米修斯”超算集群,新模型训练算力较上代提升一个数量级。Muse Wonder 的发布,意味着这场前沿竞赛的格局再次出现变数。
读者评论 (1)
想参与讨论?请 登录 后发表评论。
不开放权重还吹前沿,这API价格比吃顿火锅还贵,真敢要钱