国内首个物理AI推理系统PhysisServe发布:输出频率最高3900赫兹
近日,由逆矩阵联合智源研究院、北京大学、vLLM团队共同研发的国内首个兼顾智能能力与高频吞吐的物理AI推理系统PhysisServe正式对外发布。该系统实现百亿参数量级世界模型达到千赫兹级实时输出频率,性能较现有前沿技术提升一至两个数量级,为物理人工智能走向真实场景落地打通关键技术路径。
物理AI要解决的核心矛盾,是世界模型的参数量与输出频率难以同步提升:模型参数量越大,对物理世界的理解预测精度越高,但受推理框架限制,输出实时性往往随之下降。而具身智能、工业仿真、科学预测等真实场景,要求AI在充满噪声、干扰的动态环境中理解环境演变规律、预判干预结果,并完成记忆更新与任务切换,对推理系统的规模和速度都提出了刚性要求。
技术路线上,Action-Conditioned World Model(ACWM)、World Action Model(WAM)这类主流世界模型采用自回归去噪方式生成内容,以数据块(chunk)为单位生成连续帧。与大语言模型逐Token生成不同,自回归去噪的后序数据块无需等待前序数据块完全处理完毕,去噪计算可以交错重叠执行,并行能力能够跟随算力规模扩展,与物理世界毫秒级动态变化的特性高度匹配。
基于这一特性,PhysisServe提出分层级流水线架构,以stage作为算力分配、调度的基本单元,从三个维度完成系统设计:单路性能上,系统实现去噪步、Transformer模块双维度流水线化,扩大模型规模、增加去噪步数主要增加流水线深度,不会直接拉低输出频率;算力利用上,计算单元与物理显卡解耦,一张显卡可在不同时间周期轮询处理多项计算任务,调度器对同源不同任务合并批处理,非极限延迟场景下用更少硬件即可满足业务指标;多任务并发上,系统引入虚拟rank动态放置机制,将单条业务流各阶段的计算任务封装为虚拟单元并动态映射到物理显卡,新任务接入时按显卡剩余资源智能分配,已运行任务不发生迁移。
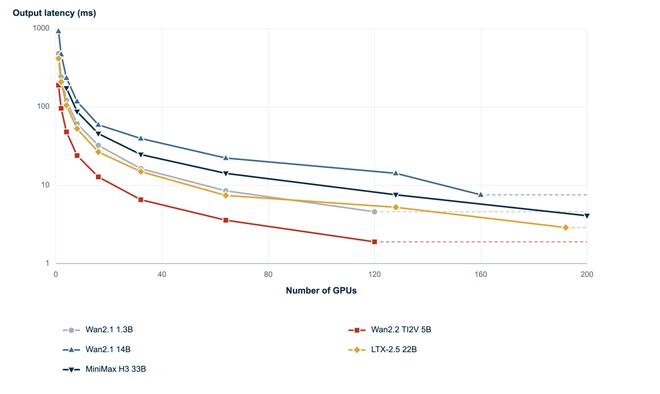
研发团队选取Wan2.1 1.3B、Wan2.2 TI2V 5B、Wan2.1 14B、LTX-2.5 22B、MiniMax H3 33B五款主流骨干模型开展实测,全部模型均未做剪枝、压缩、量化处理。实测数据显示,在硬件充分供给条件下,33B规模的MiniMax H3模型单路极限输出延迟仅4.1毫秒,作为ACWM模型可实现约每秒1000帧输出,作为WAM模型最高输出频率可达3900赫兹。这意味着只要算力充足,即便物理智能基座扩展至百亿、千亿乃至万亿参数级别,依旧能够按业务需要持续实时输出。
在业内看来,PhysisServe的推出迈出了大参数物理AI适配现实世界实时节奏的重要一步,为具身机器人、工业仿真推演、复杂系统科学预测等应用筑牢了底层推理基础设施。研发方表示,智源研究院与逆矩阵还将持续输出通用物理智能方向的系列研究成果,围绕通用世界基座模型开展持续探索。
读者评论 (0)
想参与讨论?请 登录 后发表评论。
还没有评论,欢迎抢沙发!