CoreWeave将英伟达Vera Rubin NVL72投入生产 Cognition率先用上
AI云服务商CoreWeave在9月30日于旧金山举行的Fully Connected大会上宣布,英伟达新一代机架级加速系统Vera Rubin NVL72已在CoreWeave Cloud正式投入生产,AI软件公司Cognition成为全世界首个在该系统上运行生产负载的客户。
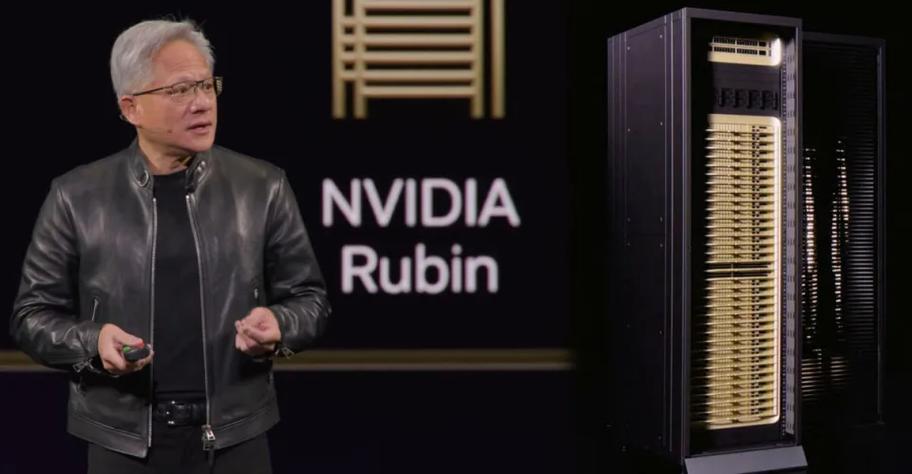
Vera Rubin NVL72由36颗Vera CPU与72颗Rubin GPU组成,采用100%全液冷设计,并以无缆线模块化托盘将单机柜部署时间从约两小时压缩到五分钟。Cognition正是开发AI编程智能体Devin的公司,其在新系统上运行自家的SWE-2推理基准,实测总Token吞吐量较上一代GB200 NVL72提升最高4.8倍;在强化学习回放场景中,每GPU输出Token吞吐量也达到上代的3.8倍。在DeepSeek-R1推理基准上,新系统每兆瓦Token吞吐量更是达到GB200的10倍。
对Cognition这类智能体编码工作负载而言,长上下文、高并发与快速推理是硬需求,每一个工程步骤都要等待上一步的模型输出。4.8倍的吞吐提升意味着Devin能在同样硬件上并行更多会话、把研究循环跑得更快,同时摊薄单次会话成本。CoreWeave还同步推出Forge开发环境,把实验追踪、模型评估与生产部署整合为统一层,并单独提供Vera CPU计算层——单机架128颗Vera CPU、总计11264核,可支撑超过11000个并发隔离环境,智能体沙箱启动比传统x86快三倍以上。
把最新一代英伟达平台在发布后迅速推向生产,正成为云厂商争夺AI开发者的关键卖点。CoreWeave自2017年Volta时代起就与英伟达深度合作,强调跨代软件平台的一致性,让客户无需重写基础设施即可切换到新架构。对DeepSeek等模型方与Cognition这类应用方来说,代际升级从“跑分”走向真实智能体负载,意味着底层算力正以可观幅度拉开代差;而对整个行业,谁先锁定新一代机架级算力,谁就能在agentic时代抢到更便宜、更稳定的推理产能。
读者评论 (0)
想参与讨论?请 登录 后发表评论。
还没有评论,欢迎抢沙发!