MiniMax发布M3.1 Flash,推理提速近3倍、使用成本降低70%
10月19日晚,国产大模型厂商MiniMax正式发布新一代Flash模型M3.1 Flash。此前以匿名身份“太空兔”(Space Bunny)处理了超过200万亿Token的模型,正是M3.1 Flash的早期版本。作为面向智能体场景的新一代Flash模型,它在复杂任务、编程、电脑操作与网络安全等能力上实现了代际提升,同时线上推理速度近乎提升3倍、使用成本降低70%。
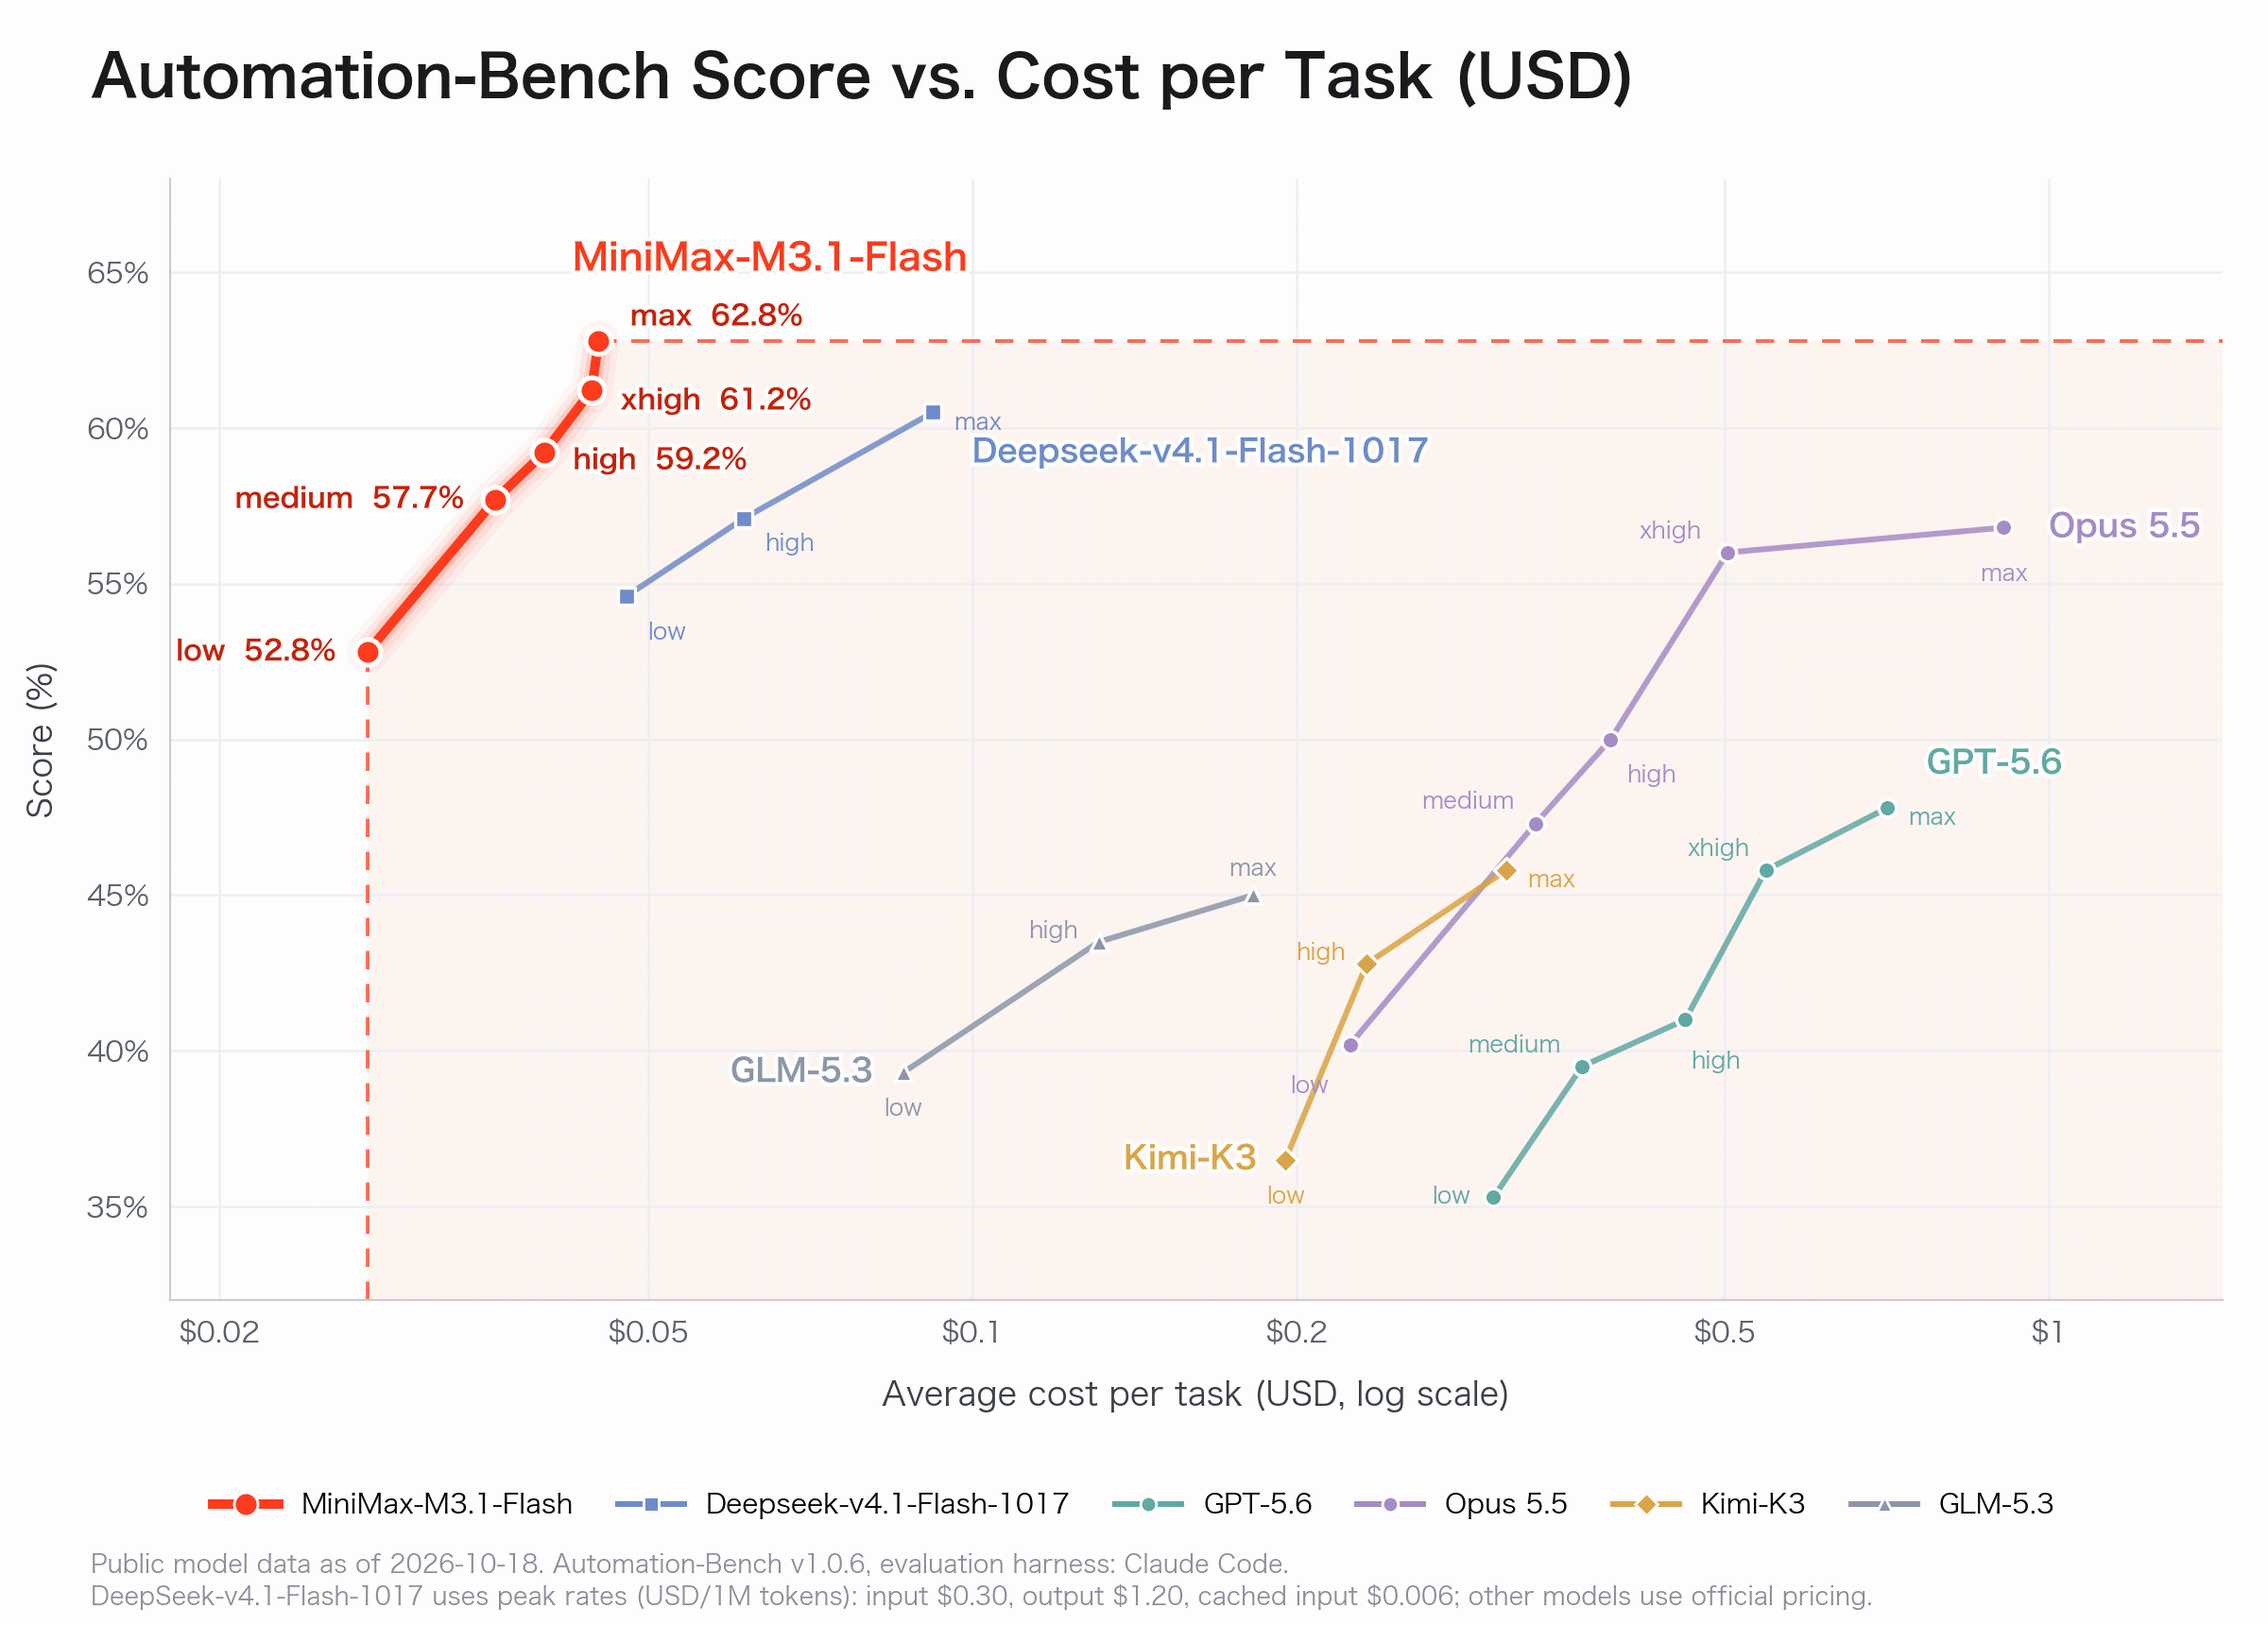
在能力维度上,M3.1 Flash的升级是全方位的。智能体任务方面,它在AutomationBench-AA等基准上跻身前列,能够跨SaaS系统完成真实的企业工作流,覆盖销售、营销、运营、客服、财务与人力资源等场景。编程与软件工程方面,它在DeepSWE v1.1评测中取得73.7%的成绩,可进行长链路任务执行,以更低成本支撑复杂开发工作流;电脑操作方面,它在OSWorld V2与ALE两项基准上均居国产模型第一;网络安全方面,它在CyberGym上取得82%的得分,在代码审计、漏洞修复、渗透测试等环节表现突出。
速度与经济性是这次更新的另一大看点。MiniMax通过更激进的稀疏注意力架构优化推理效率,日常输出速度可达200+ TPS(每秒Token数),中位数(P50)稳定达到170+ TPS。在定价上,模型每百万Token输入0.15美元、输出0.60美元、缓存读取0.015美元,相较前代整体使用成本下降约70%。API价格同步下调后,每百万Token输入仅1元、输出4元,输入与输出单价均降低50%以上。
值得一提的是MiniMax的发布策略:先用匿名模型“太空兔”跑完200万亿Token的实战检验,再以真名正式发布。这种做法既规避了品牌预期对评测的干扰,也显示出团队对产品力的信心。据官方预告,追求更高智能上限的Pro版本也将在不久后推出。
从行业视角看,M3.1 Flash延续了近期国产Flash模型向复杂任务“主力化”靠拢的趋势。短短72小时内,DeepSeek刚更新V4.1-Flash-1017,MiniMax随即发布M3.1 Flash,两家头部厂商在复杂任务上的竞争更加直接。当Flash模型拿出足以对标旗舰的评测分数,“强代码能力必须依赖旗舰大模型”的固有认知正在被打破——开发者可以以更低成本,获得接近旗舰的执行能力。
读者评论 (0)
想参与讨论?请 登录 后发表评论。
还没有评论,欢迎抢沙发!