蚂蚁开源5600亿参数医疗大模型LingSante-3.1-flash,MIT许可可商用
11月22日,蚂蚁集团旗下AI团队Ant Ling正式开源医疗大模型LingSante-3.1-flash。这是一个总参数5600亿、每token激活250亿的混合专家(MoE)模型,权重以MIT许可发布在Hugging Face和ModelScope,同时提供MXFP4量化版本。值得注意的是,FP8权重在11月19日就已上传仓库,官方社交账号的发布帖到22日深夜才发出。
模型基于蚂蚁通用模型Ling-3.1-flash,替换上一代1240亿参数的Ling-3.0-flash-Sante。架构沿用混合线性注意力:63层KDA加9层门控MLA,比例7比1,另有4层稠密层,512个路由专家、每token激活8个,外加1个共享专家。模型卡宣称支持100万token上下文,但仓库config.json里的max_position_embeddings为262144,部署前需要先对齐这两个数字。
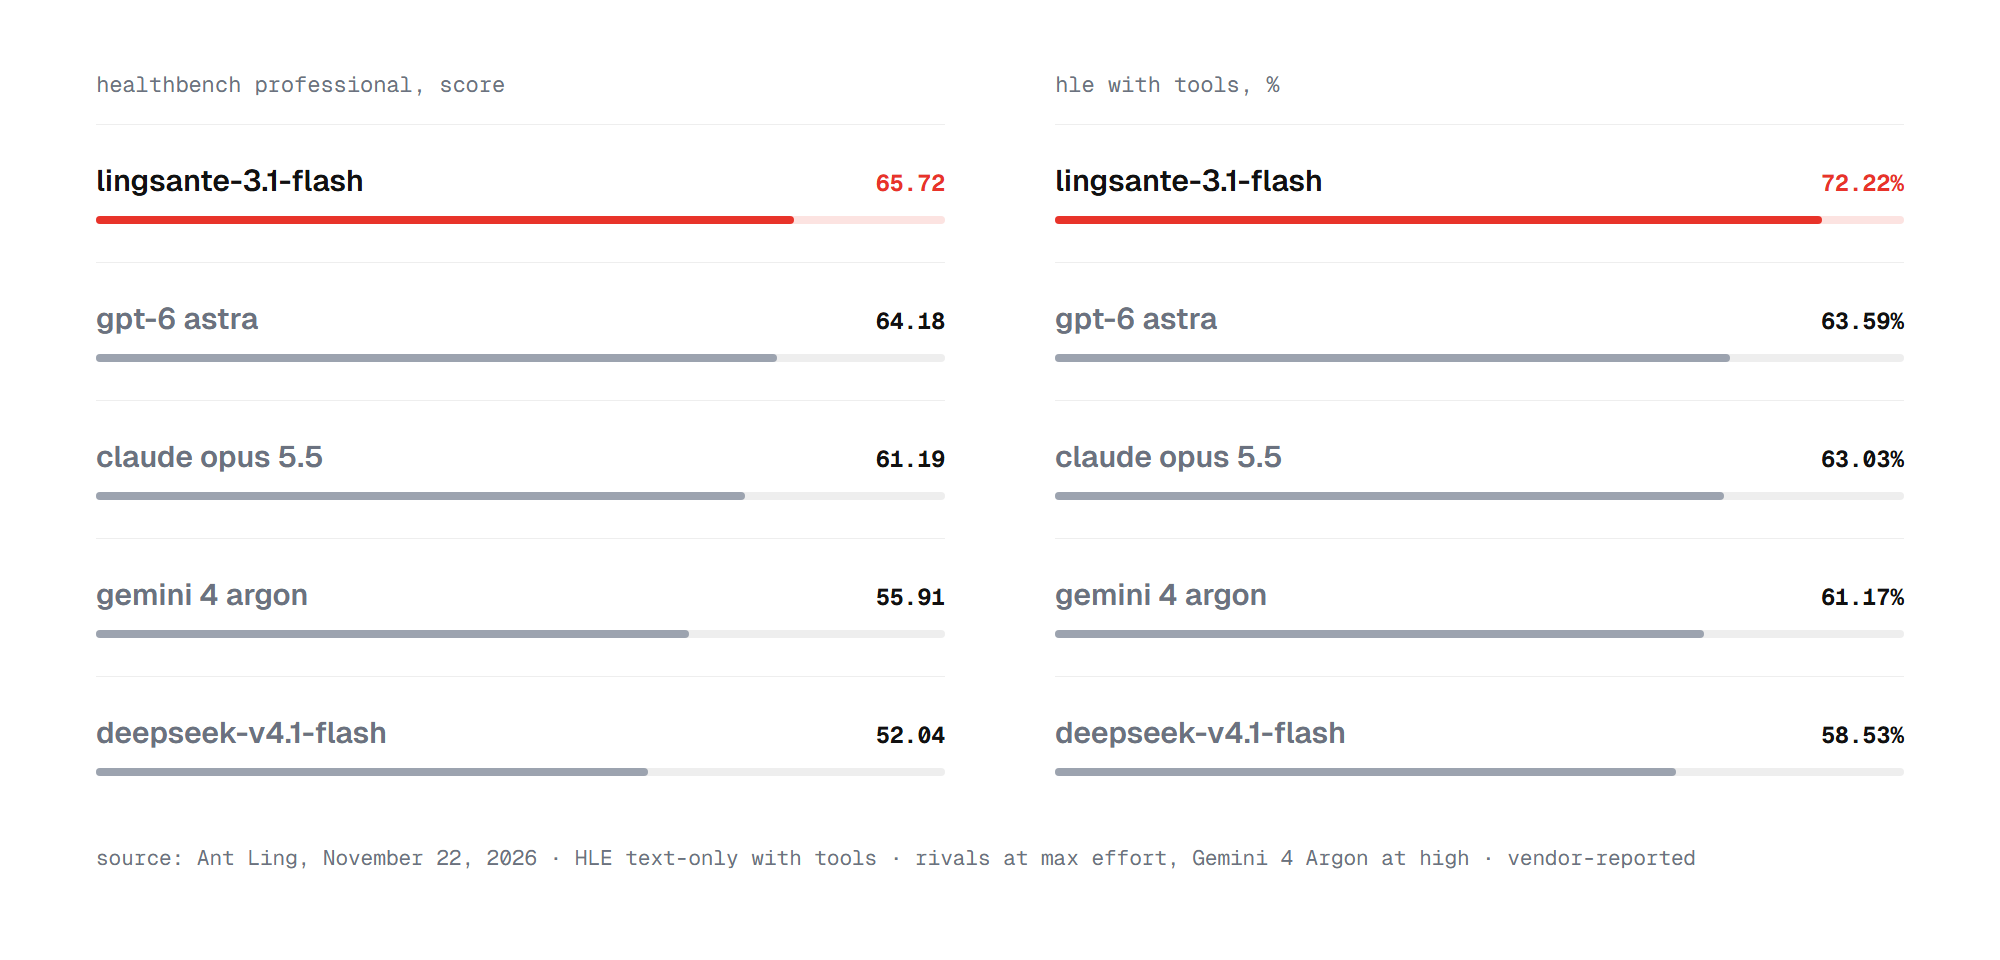
官方给出的三项领先分数都来自自家评测:HealthBench Professional 65.72,略高于GPT-6 Astra的64.18;带工具的HLE(纯文本)72.22%,高于Kimi-K3.1-Pro的70.00%和Astra的63.59%;带上下文的BrowseComp 94.10%。在电子病历任务EHR-Complex上得分74.40,领先Astra的74.20。
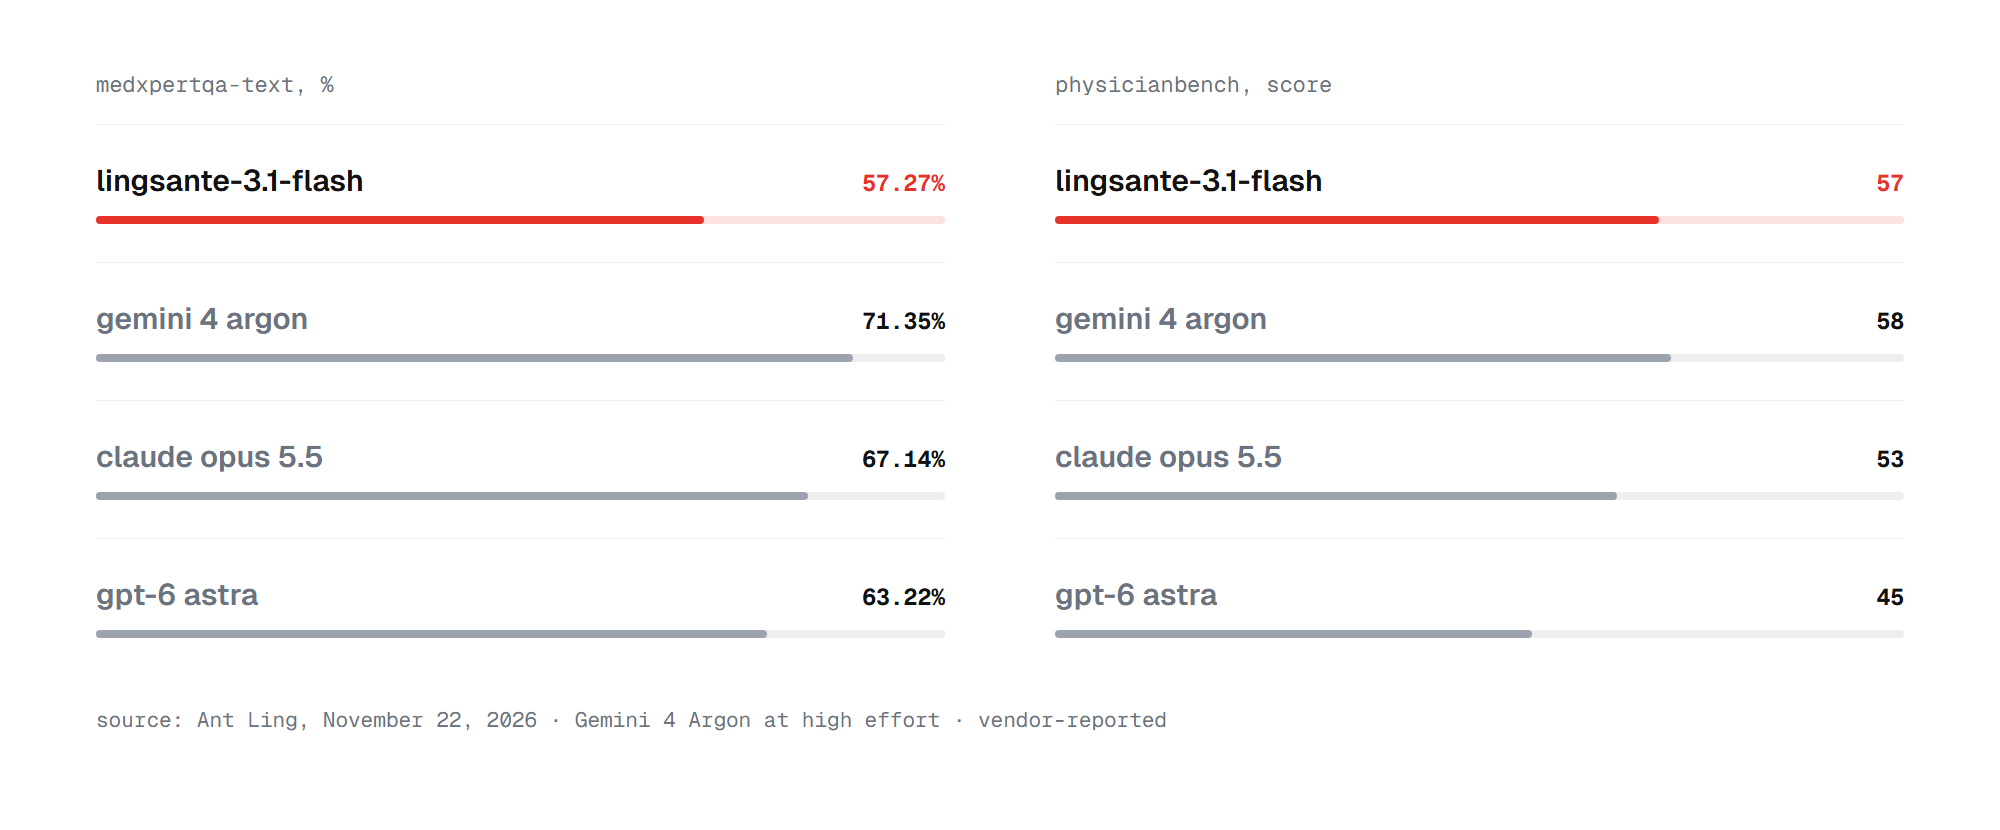
但这不是全面领先。同一张图上,MedXpertQA-Text只拿到57.27%,明显落后Gemini 4 Argon的71.35%和Claude Opus 5.5的67.14%;PhysicianBench为57分,落后Argon一分;三项医疗行为均值61.21,仍低于Astra的62.54;诊断选择题DiagnosisArena-MCQ为83.9对84.7,心理健康基准54.64对57.50。16个图表中有4个是蚂蚁内部基准,外部无法复核。
训练方法上,蚂蚁强调三件事:用“证据—能力匹配”把医学证据映射到推理目标,样本经多智能体审核、通过医学正确性与任务一致性检查后才进入训练;用贡献感知的多智能体搜索奖励,在提升准确率的同时把总搜索步数降低20%以上;用行为矩阵提供奖励,官方称医师标注一致率达到99.62%。最终通过多教师on-policy蒸馏把能力合并进一个模型。
门槛在硬件。官方推荐8张H200(TP8+EP8)或4台GB300,配SGLang镜像并启用MTP投机解码,vLLM配置也已公布。FP8权重约578GB,MXFP4版本约291.72GiB,可在4张H20-3e上运行。走API则指向Computrix平台,免费额度需搭配每月20美元的基础套餐。这不是能在笔记本上跑的小模型。
边界同样写得明确。模型卡把用途限定为“研究与评测”,声明它不是医疗器械,“不得作为诊断、处方或治疗的独立依据”,基准测试和模拟环境的结果也不构成临床有效性证据。对想在本院数据上做微调的团队,MIT许可确实降低了门槛,但从权重到临床工作流之间,还隔着数据治理、验证与责任划分。
读者评论 (0)
想参与讨论?请 登录 后发表评论。
还没有评论,欢迎抢沙发!