Ai2 开源 Olmo-core 3,万亿参数 MoE 训练吞吐提升 2.7 倍
10月1日,艾伦人工智能研究院(Ai2)开源 Olmo-core 3 训练框架,专为大模型混合专家(MoE)架构设计,可扩展至万亿参数。在 8 张英伟达 B300 上,47B MoE 吞吐达旧实现 2.7 倍,并支持 MXFP8 低精度。
10月1日,非营利机构艾伦人工智能研究院(Ai2)开源了 Olmo-core 3——一套面向大模型混合专家(MoE)架构重写的训练框架。它并非新的模型权重,而是下一代 Olmo 模型的训练基座,目标是在保持计算效率的同时,把 MoE 训练扩展到万亿参数级别。
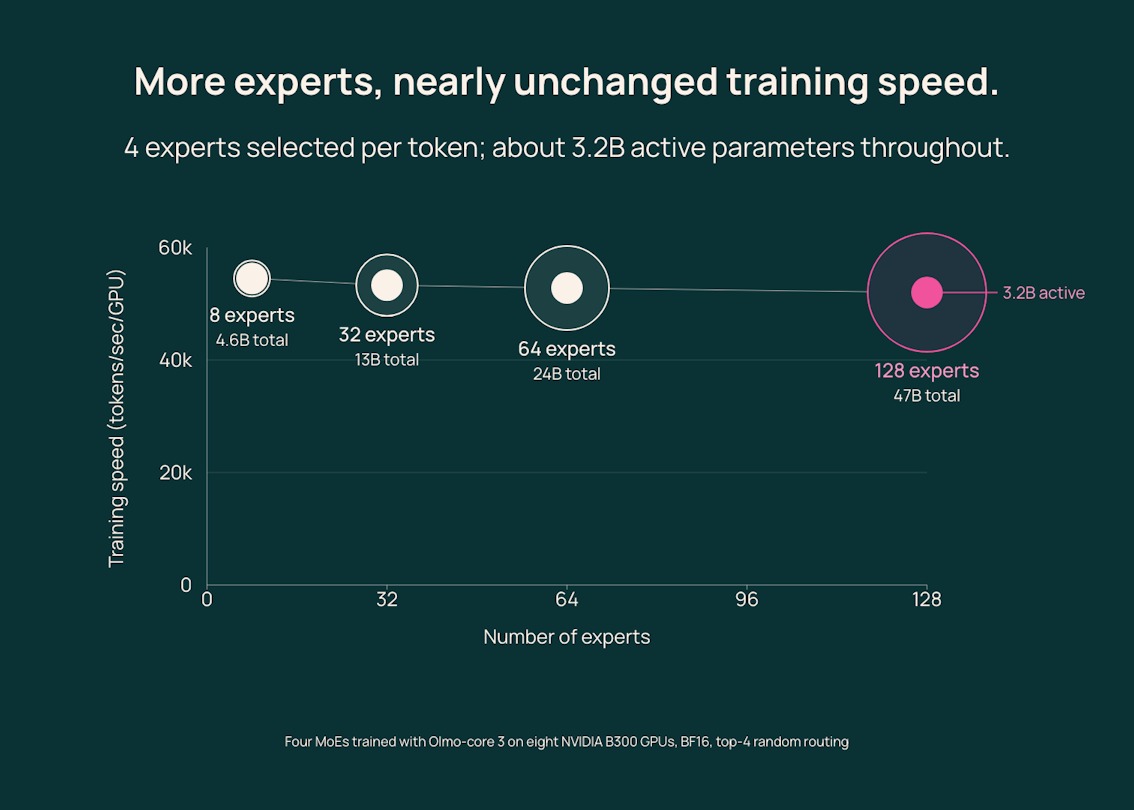
据官方技术报告,新框架在 8 张英伟达 B300 GPU 上,让一个 470 亿参数的 MoE 达到每卡每秒约 5.2 万个 token,而旧实现仅约 1.94 万,吞吐提升约 2.7 倍。关键改动是从全分片数据并行(FSDP)切换为分布式数据并行(DDP):专家常驻各自 GPU,只把数据路由过去,避免反复搬运权重。团队还把专家池从 8 个扩到 128 个、每 token 仍只激活约 4 个,总参容量从 46 亿增至 470 亿,吞吐仅降不到 5%。
Olmo-core 3 还引入行式专家并行、GPU 驻留路由与分组 GEMM 等优化,并支持 MXFP8 低精度格式:在受控测试中吞吐再提升约 21%,峰值显存从 103GB 降至 95GB。同一套基础设施已在 512 张卡上验证 1.2 万亿参数模型,峰值实测约 858 TFLOP/s/卡。对算力预算有限的高校与小型实验室,这意味着过去被大厂独占的训练规模变得可触及。
在主流训练基础设施多为闭源的背景下,Ai2 把方法先于模型公开:框架、代码、技术报告与交互讲解全部开放,直接对标英伟达 Megatron-Core。Ai2 表示,下一代 Olmo 将基于该栈训练,并采用其史上最大数据集与最长上下文。开放路线能否缩短前沿模型与中小团队之间的差距,值得持续观察。
读者评论 (0)
想参与讨论?请 登录 后发表评论。
还没有评论,欢迎抢沙发!