谷歌发布 Nano Banana 2.1 图像生成模型,原生支持 4K 输出并下调 API 价格
Google DeepMind 在 10 月 8 日凌晨正式发布 Nano Banana 2.1,这是其高效率图像生成与对话式编辑模型的一次小幅但务实的升级。新模型已作为稳定版本接入 Gemini API,模型 ID 为 gemini-nano-banana-2.1,并同步分发到 Gemini App、Google AI Studio、Google Search AI Mode、Flow 与 Stitch 等平台。
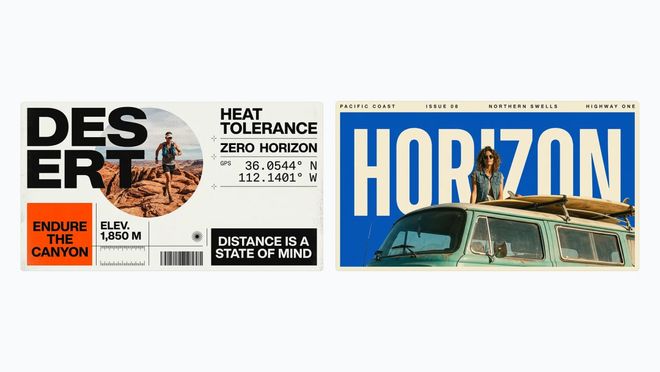
从定位看,Nano Banana 2.1 仍基于 Gemini 3.6 Flash 底座,延续 Flash 级的速度与成本效率,但把重心压在真实生产场景最易出问题的地方。谷歌在官方展示中强调“设计感”的提升:模型需要理解完整的平面设计要求,把字体、图片、色块和版式组织到同一画面,而非只生成单个主体。在开启 Thinking 的情况下,其 Infographic Design 评分从上一版的 961 升至 1048,整体偏好评分也从 990 升至 1050。
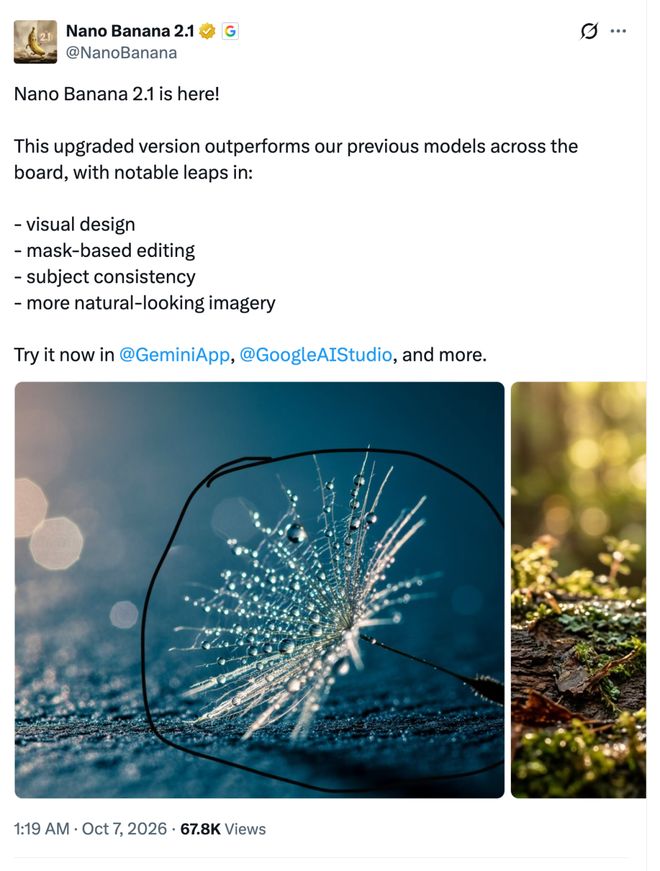
局部编辑是另一项重点。基于蒙版的 Mask-based Editing 让用户可以圈出图中物体、改变周围环境而保留主体,Nano Banana 2.1 在这项评分上从 965 提升到 1049,广义 General Editing 也从 938 提升到 1026。多角色一致性同样明显增强:单角色一致性由 981 升至 1028,多角色一致性由 978 跃升至 1106,使商业设计中“素材复用”成为可能。
在输出规格上,新模型支持 1K、2K 与 4K 分辨率,并专门优化了 1:4、4:1、1:8、8:1 等宽幅与超宽幅画面的平铺伪影问题;多图融合最高可接收 14 张参考图,保持最多 4 个角色与 10 个对象的一致性。据 AI Market Watch 汇总,1K 与 2K 图像的 API 生成价格下降约一半,4K 价格下降约 25%,进一步压低了商业设计的单位成本。
谷歌也延续了信息图路线:模型可借助 Gemini 的世界知识与 Google 搜索进行 grounding,先理解内容再组织版式。不过模型卡也坦诚其局限——小字号文字仍可能模糊、长段落文本渲染有限、连续编辑的一致性并非始终稳定,且左右空间关系偶尔判断失误。

总体来看,Nano Banana 2.1 并非参数或架构上的大跨越,而是把“会生成图片”进一步推向“能持续完成视觉工作”。在保持 Flash 速度的同时提高交付质量,谷歌正把图像生成模型更深地嵌入广告、电商、海报与 UI 等真实工作流。
读者评论 (0)
想参与讨论?请 登录 后发表评论。
还没有评论,欢迎抢沙发!