MiniMax发布M3.1 Flash新一代模型 推理提速3倍成本降70%
10月19日晚,国产AI公司MiniMax正式发布新一代Flash模型M3.1 Flash。此前以匿名身份处理了超过200万亿Token的“Space Bunny”模型,正是该版本的早期形态。新模型在智能体(Agentic)任务、编程、Computer Use与网络安全等方向上实现代际提升,同时把线上推理速度提升近3倍、综合使用成本降低70%。
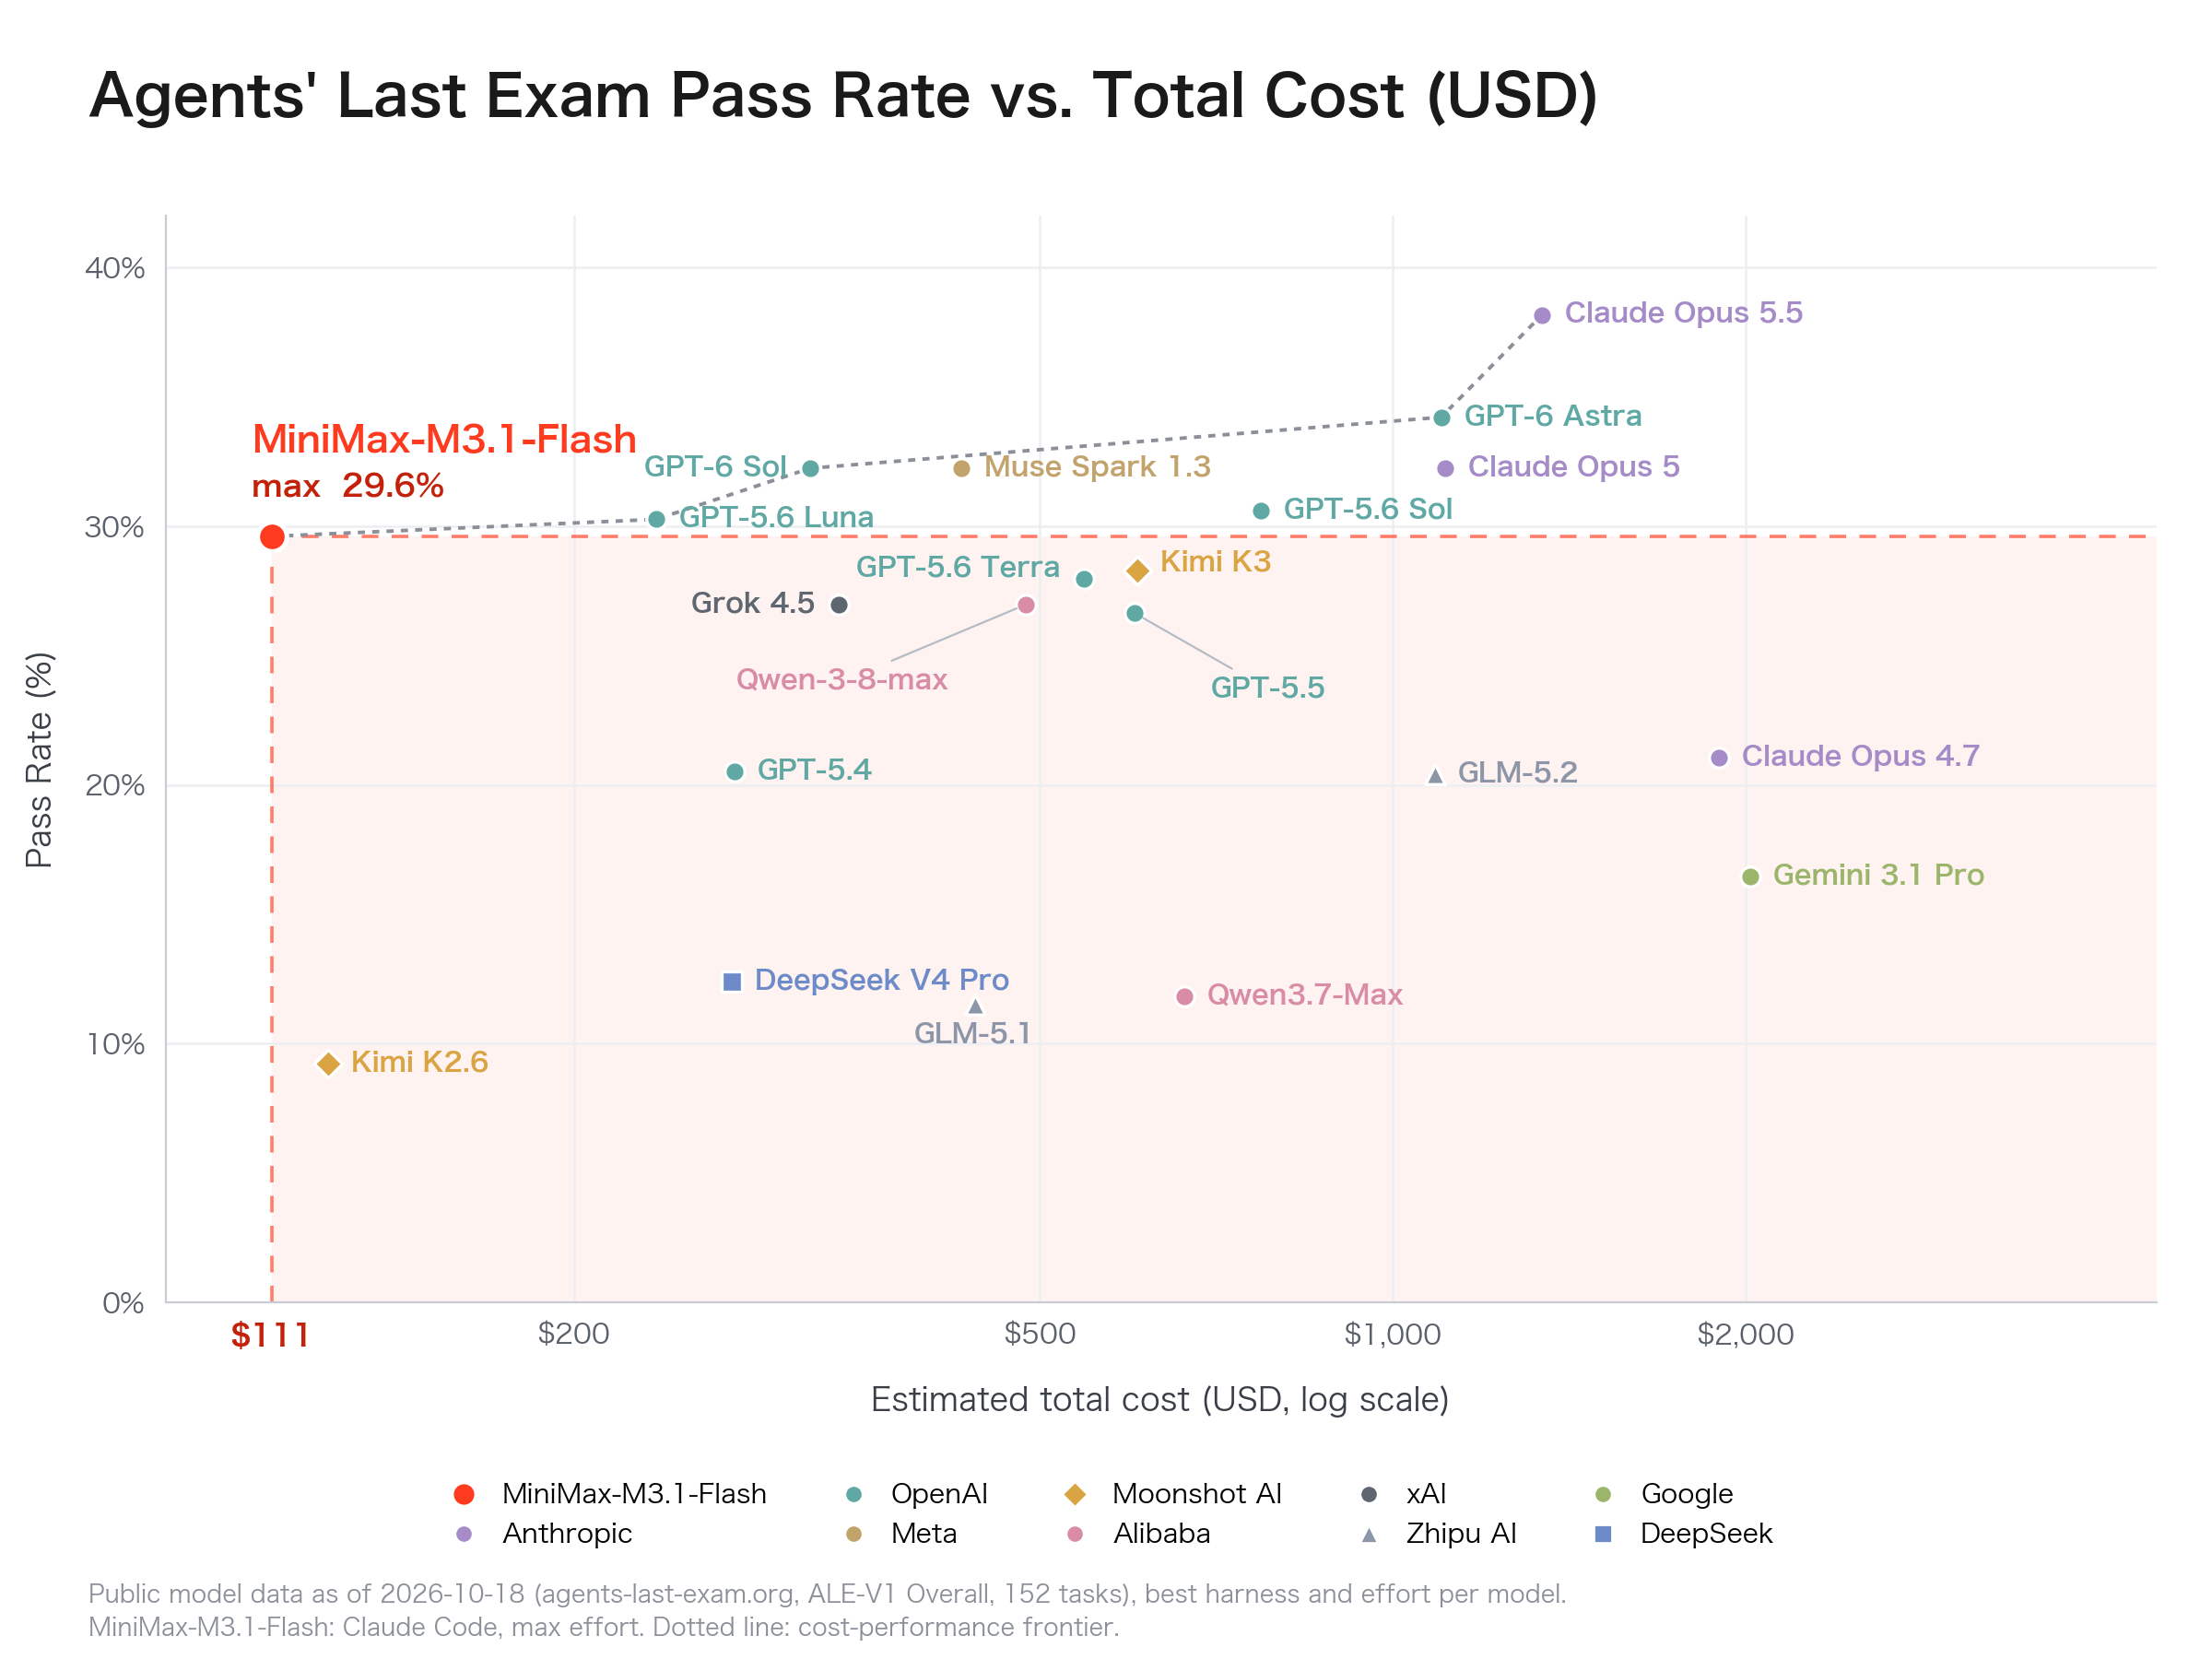
在能力维度,M3.1 Flash在多项基准上逼近头部模型:复杂任务自动化AutomationBench-AA位居前列,BankerToolBench取得76.2分;编程评测DeepSWE v1.1达到73.7%;Computer Use方面,OSWorld V2取得61.7分、Agents' Last Exam取得29.6分,两项均列国产模型第一;网络安全基准CyberGym更是拿下82%的高分。
效率与成本是该模型的核心卖点。MiniMax采用更激进的稀疏注意力架构,日常输出速度可达200+ TPS,中位数稳定达到170+ TPS。价格同步下调,每百万Token输入仅1元、输出4元、缓存读取0.1元,较上一代M3输入输出单价均降低50%以上。在Agentic类任务中,综合使用成本较前代下降70%。
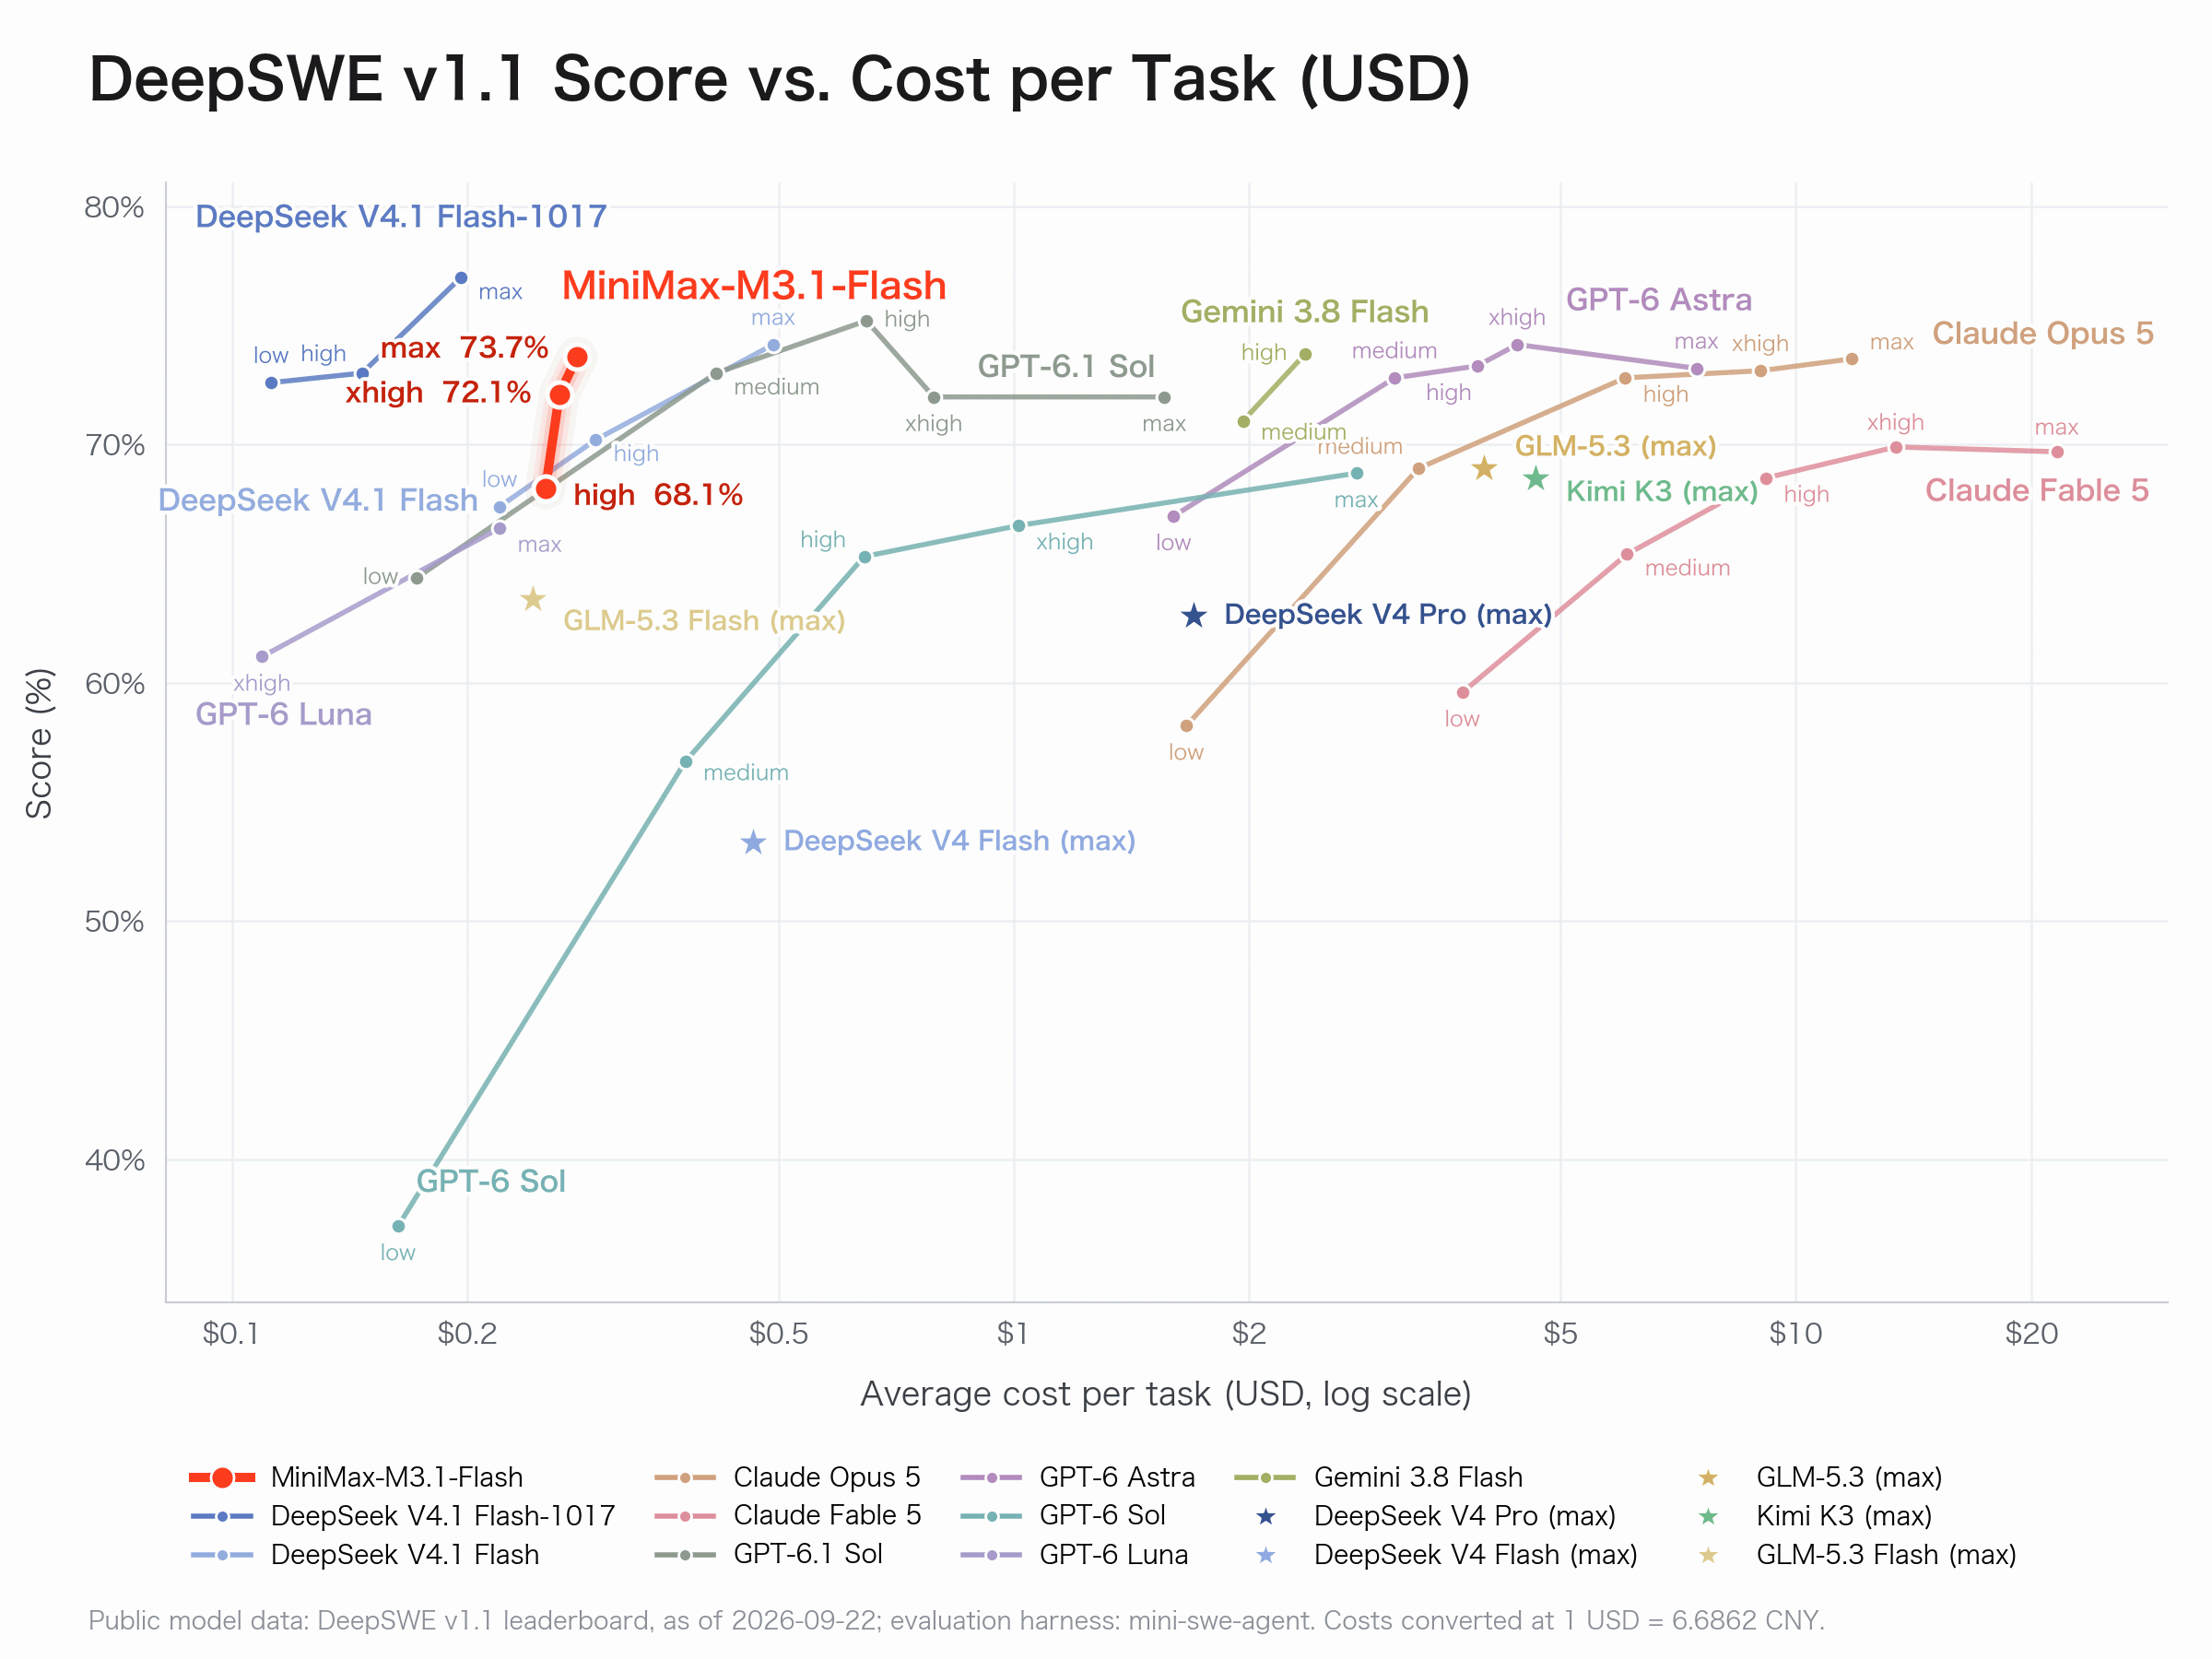
从行业视角看,M3.1 Flash延续了近期国产Flash模型的“高效低成本”路线。就在不久前,DeepSeek开源V4.1 Flash 1017,同样以更低成本在Agentic任务上逼近更大模型。两家公司不约而同地把竞争焦点从“参数规模”转向“单位任务成本”,意味着大模型落地正从能力竞赛走向性价比竞赛。
背景上,MiniMax透露模型权重将于稍后开放,追求更高智能上限的Pro版本也将很快推出。随着API、M Plan与MiniMax Code同步上线,该公司正把M3.1 Flash直接推向企业工作流,在销售、客服、研发等真实场景中与现有商业软件正面竞争。
读者评论 (0)
想参与讨论?请 登录 后发表评论。
还没有评论,欢迎抢沙发!