百度开源文心ERNIE 5.5 Flash Base,总参数2800亿激活140亿
11月5日,百度正式开源最新基座模型文心5.5 Flash Base。该模型采用MoE架构,总参数2800亿、每token激活140亿,在33.5万亿token上完成预训练,主打高效训练与长上下文。
11月5日,百度正式开源最新基座模型文心5.5 Flash Base(ERNIE 5.5 Flash Base),向社区开放预训练终点的模型权重。作为文心5.5 Flash系列的基座版本,它面向开发者和企业,提供进一步微调与领域适配的起点。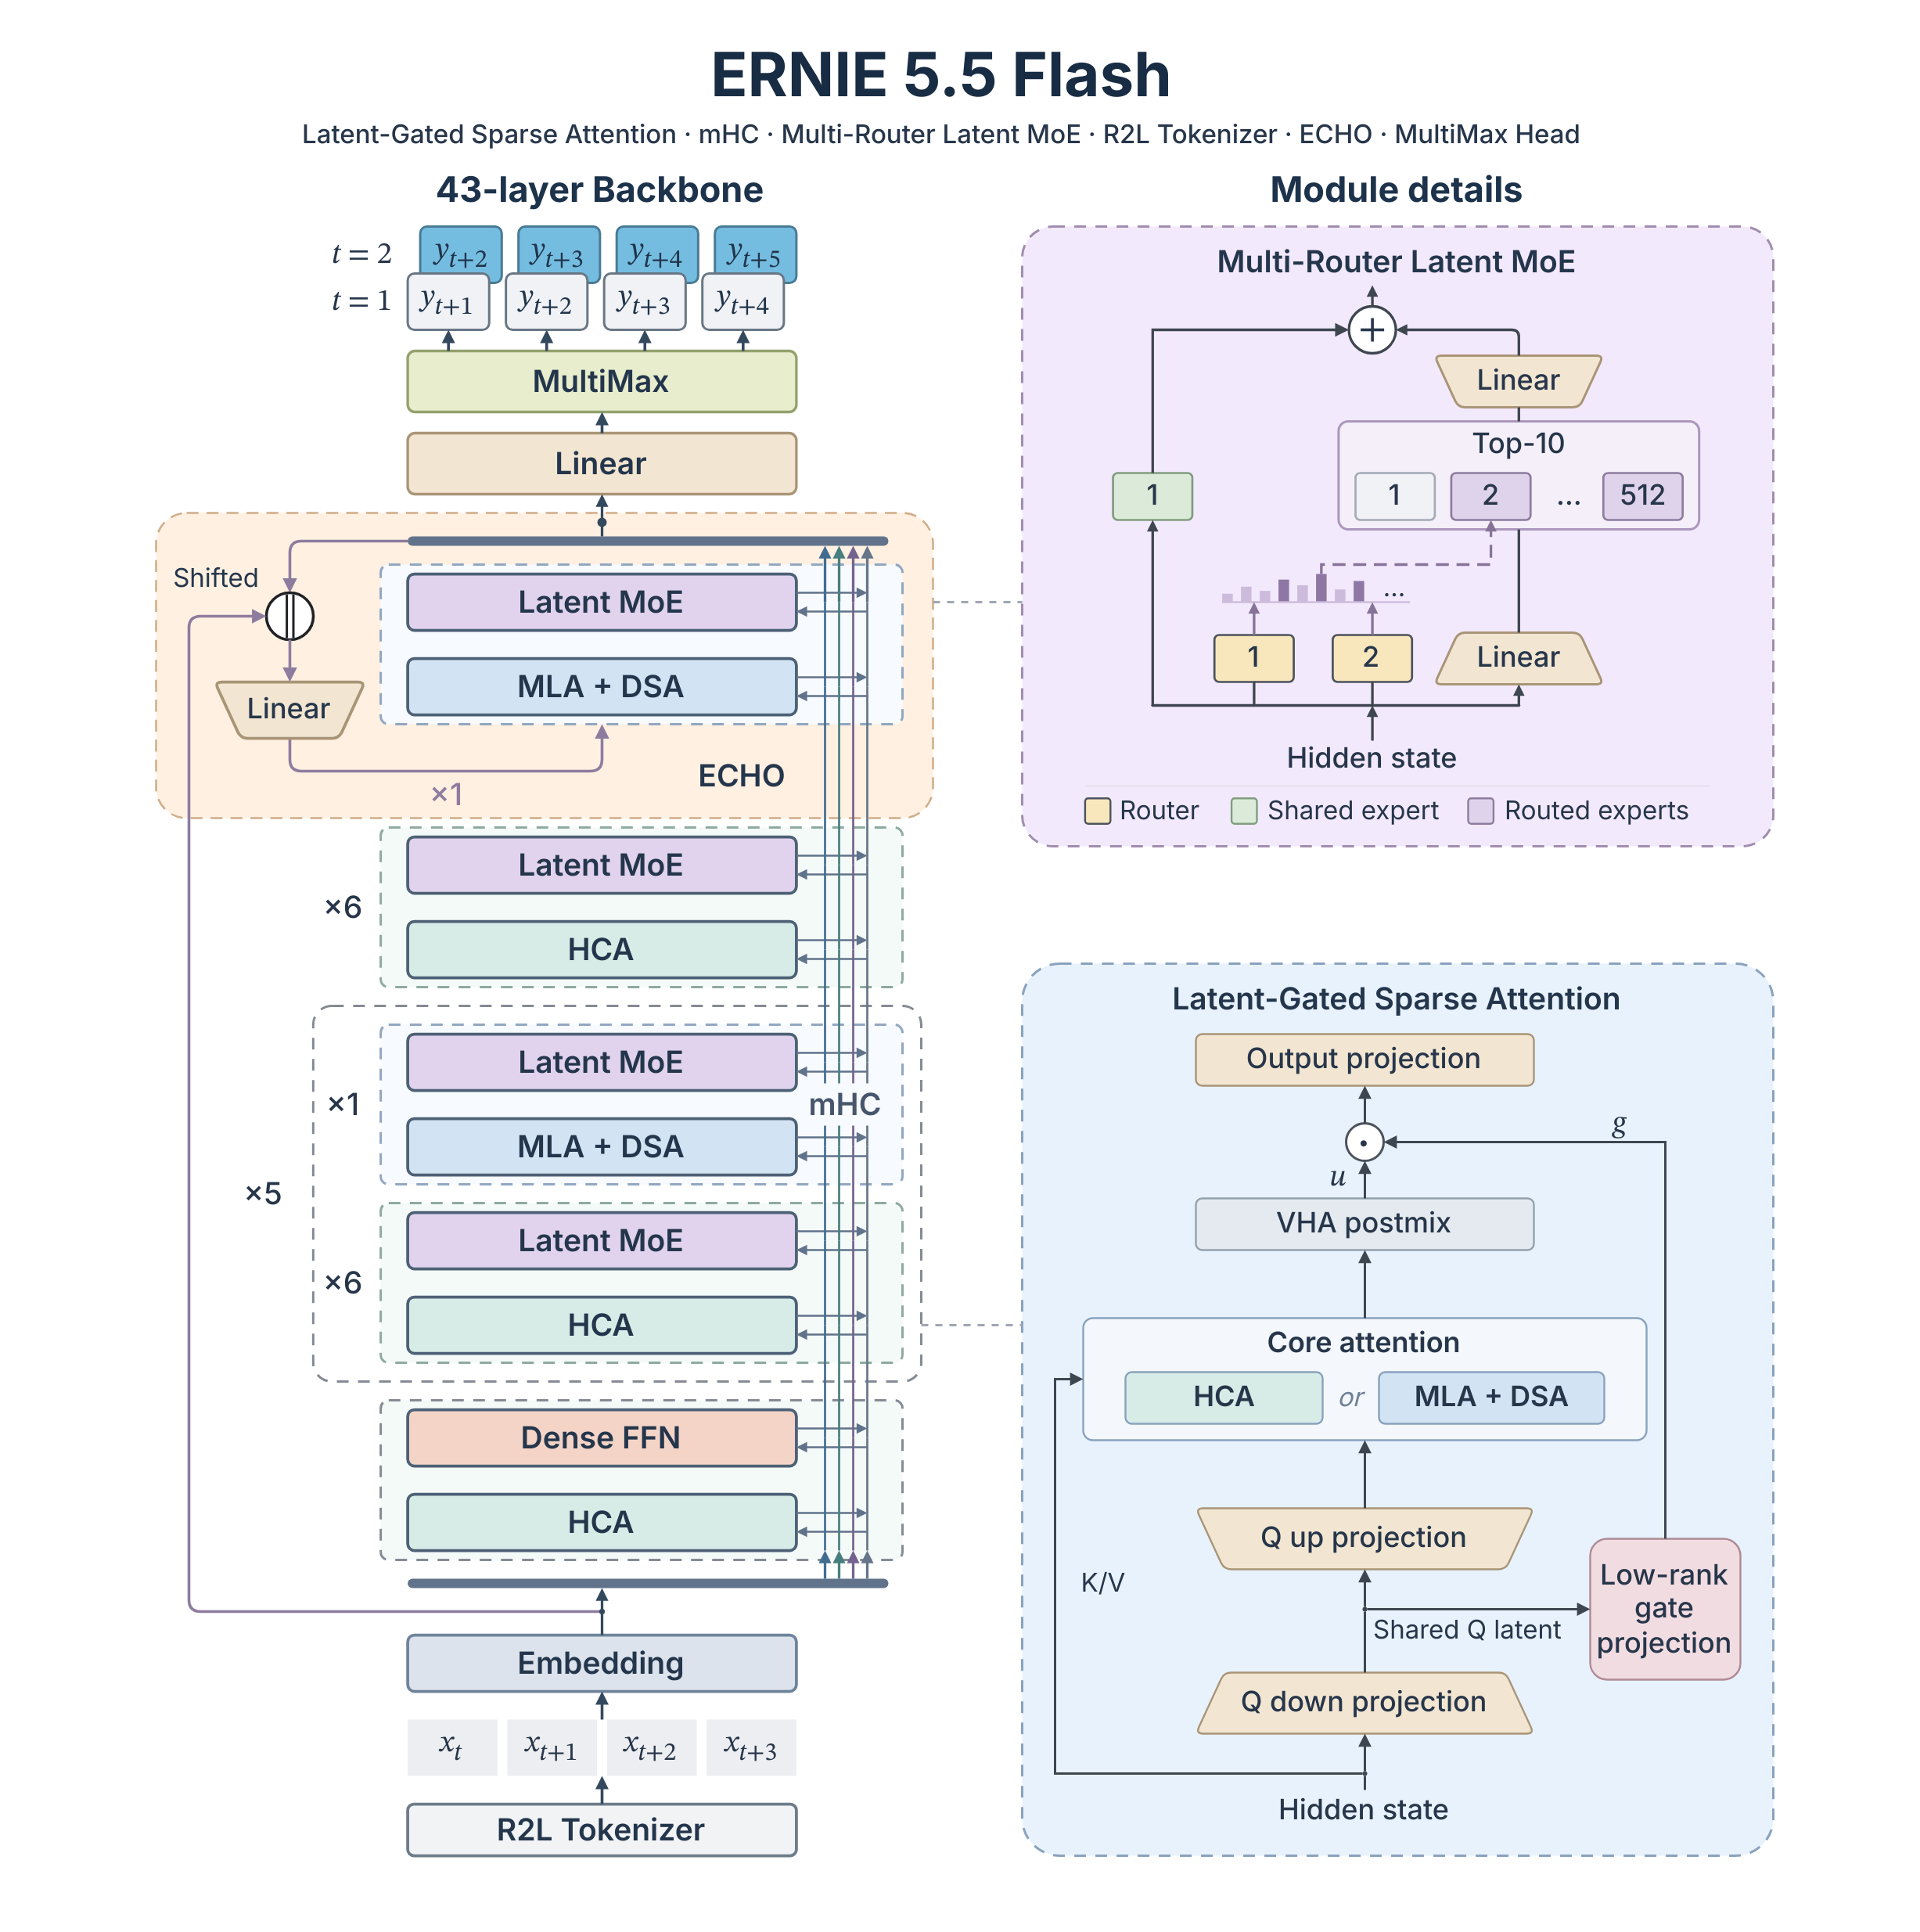
在架构上,文心5.5 Flash Base是一个稀疏MoE语言模型,总参数达到2800亿(280B),但每个token仅激活140亿(14B)参数,在33.5万亿(33.5T)个token上从零完成预训练。预训练上下文最长128K,微调与推理阶段可支持最长100万token的上下文,满足长文档分析与智能体任务的需求。
效率是这一版本的设计主线。模型在注意力机制上提出Latent-Gated Sparse Attention,组合重度压缩注意力(HCA)与多头潜在注意力(MLA),在降低长上下文开销的同时保留关键信息;专家路由采用Multi-Router Latent MoE,由多个独立路由器共同决定专家选择,提升路由稳定性;训练目标引入ECHO,复用主干最后一层预测后续token,并可作为投机解码的草稿模型。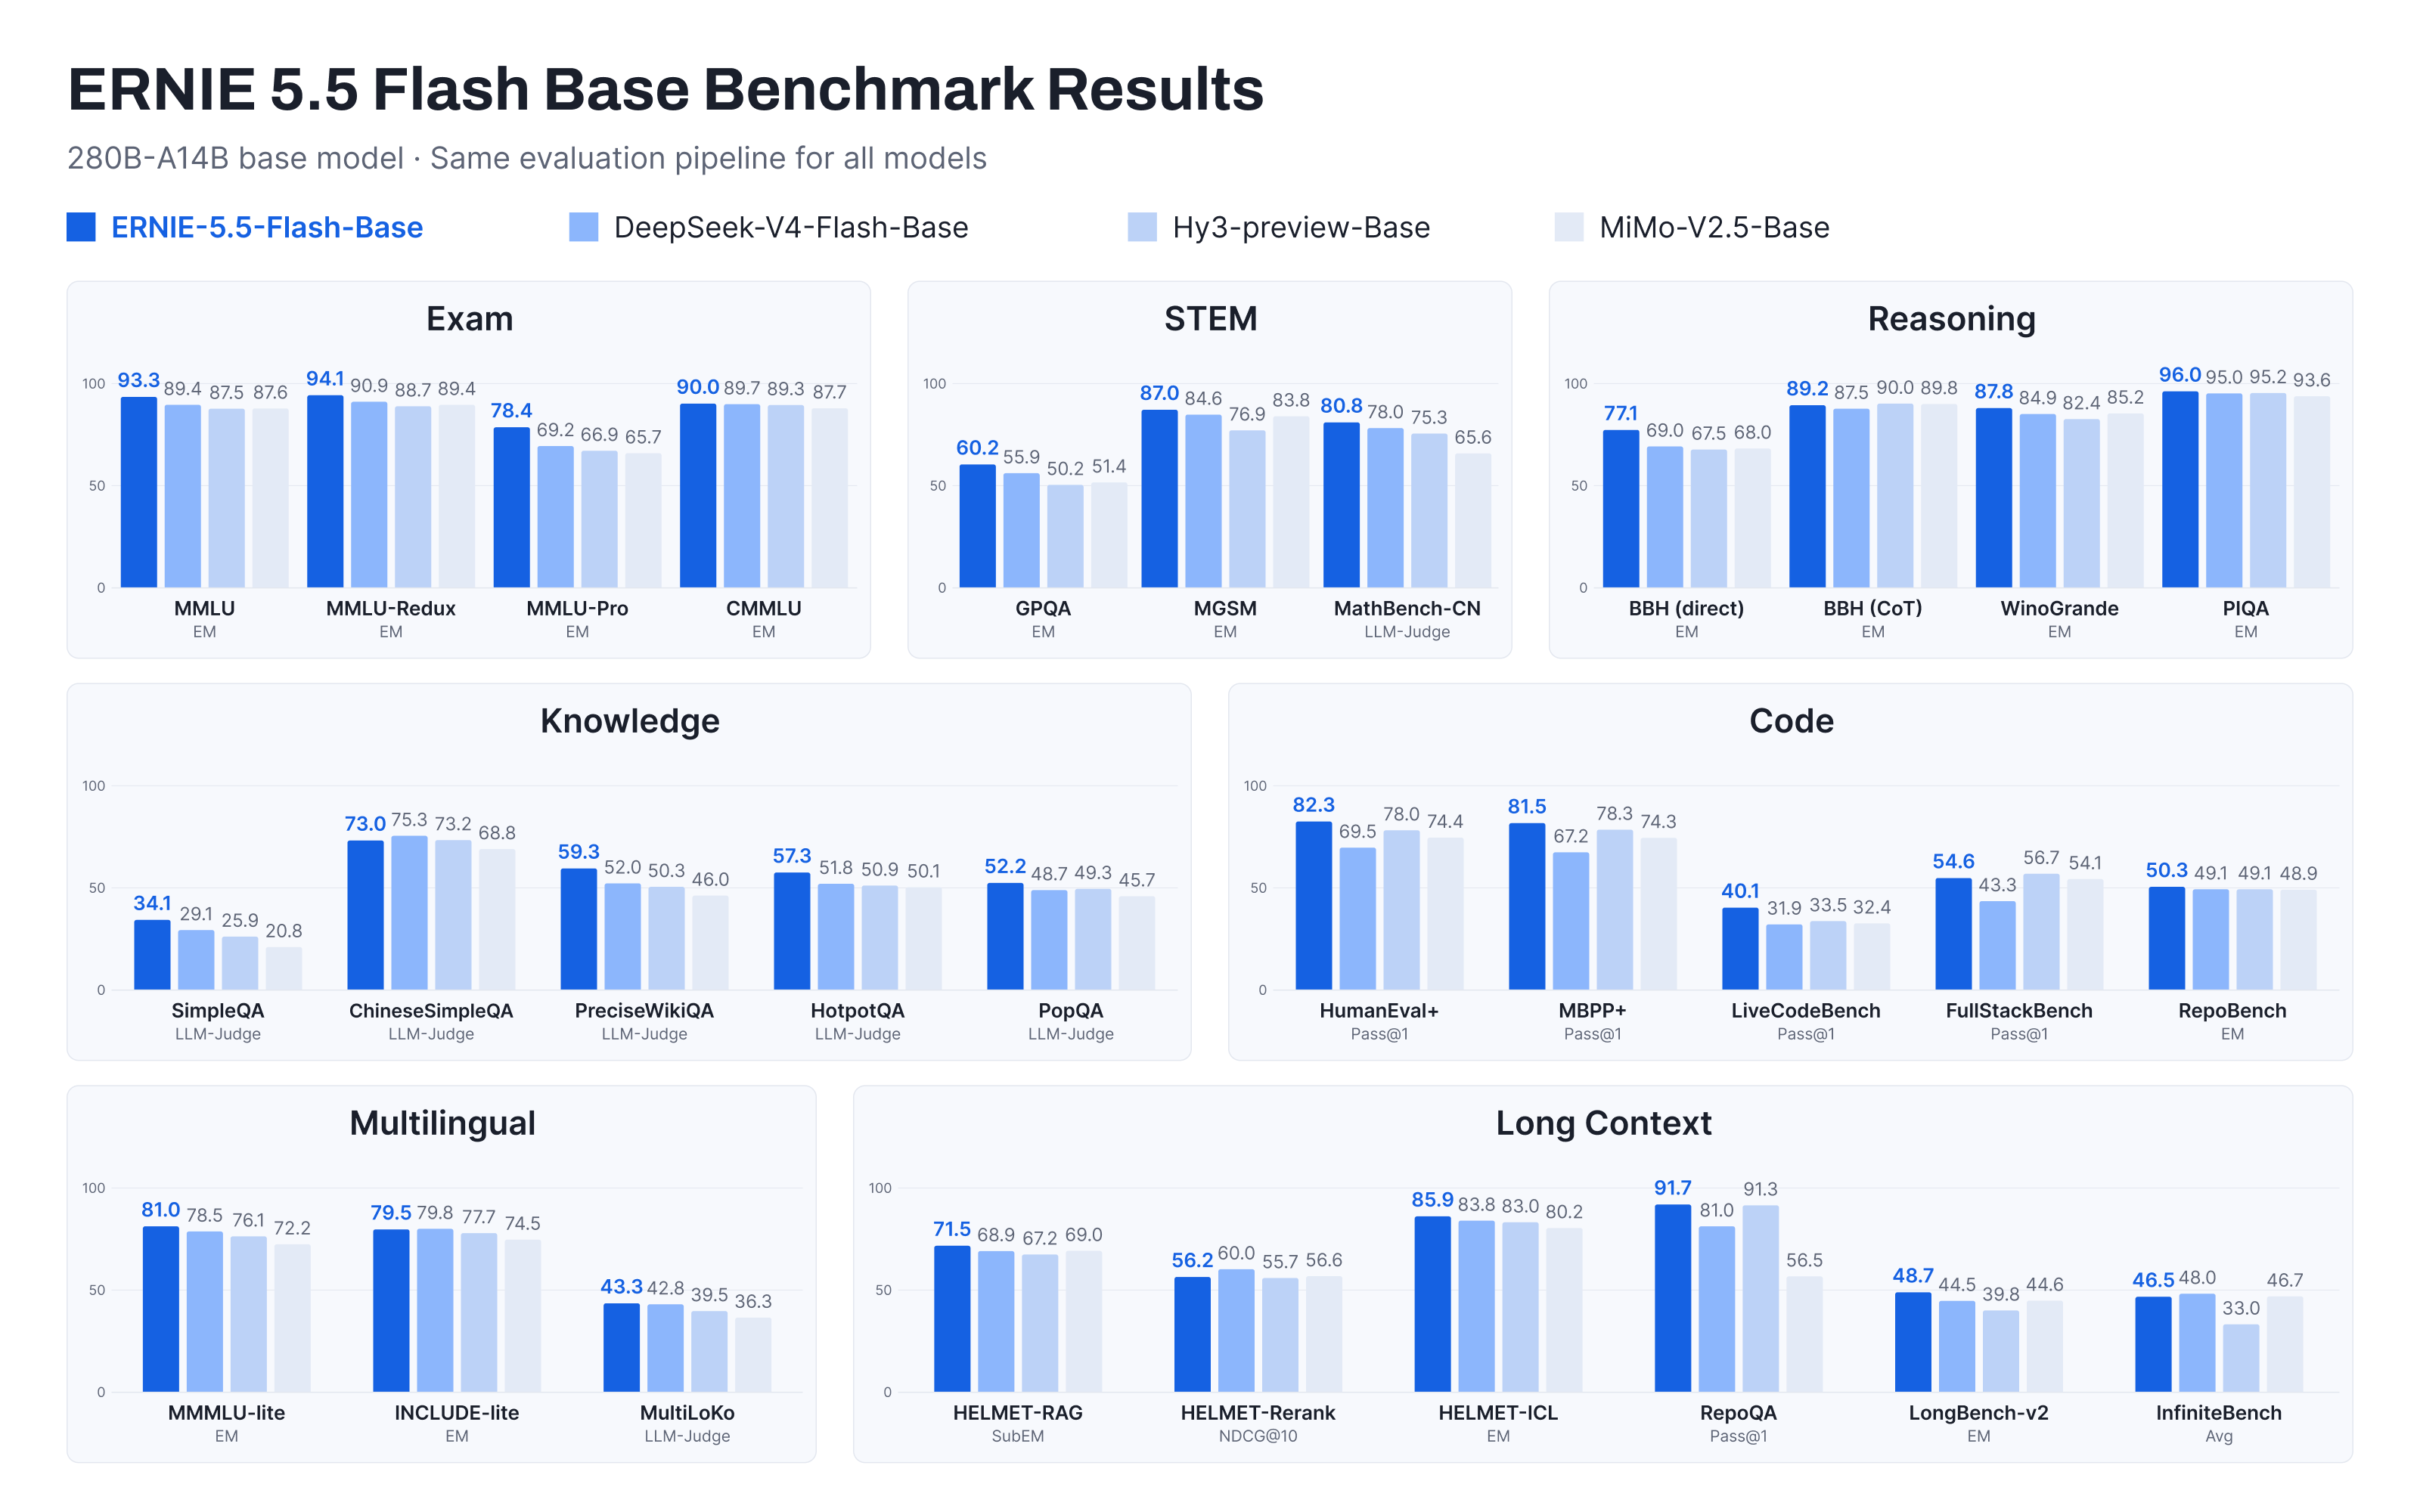
与面向终端用户的对话模型不同,Base模型未经过中训练与后训练,相当于把“预训练终点”这一阶段性成果直接开放。开发者可以在已有通用能力之上,自行选择后续训练方向,用于领域适配、指令微调和强化学习研究,从而降低专业模型开发的训练成本与技术门槛。
当前,大模型竞争正从单一能力提升,走向模型能力、训练效率与场景创新协同发展的新阶段。随着推理、Agent等技术加速演进,行业对基座模型的需求也从“更大”转向“更高效、更可定制”。百度此次开源,也加入了近期国产大模型密集开放权重的行列,为开发者提供了又一个可复用的高效训练起点。
读者评论 (0)
想参与讨论?请 登录 后发表评论。
还没有评论,欢迎抢沙发!