热点
共 502 篇 · 第 10 / 84 页
国内首个AI全产业链评测基准“求索”4.0发布:16项工具覆盖四大板块
10月13日,国内首个面向人工智能全产业链的评测基准“求索”4.0正式发布。体系分为基础软硬件、模型与智能系统、安全治理、行业落地四大板块,共16项测评工具,配套电力、医疗、钢铁等真实业务测试负载,部分轻量版工具已对外开源。
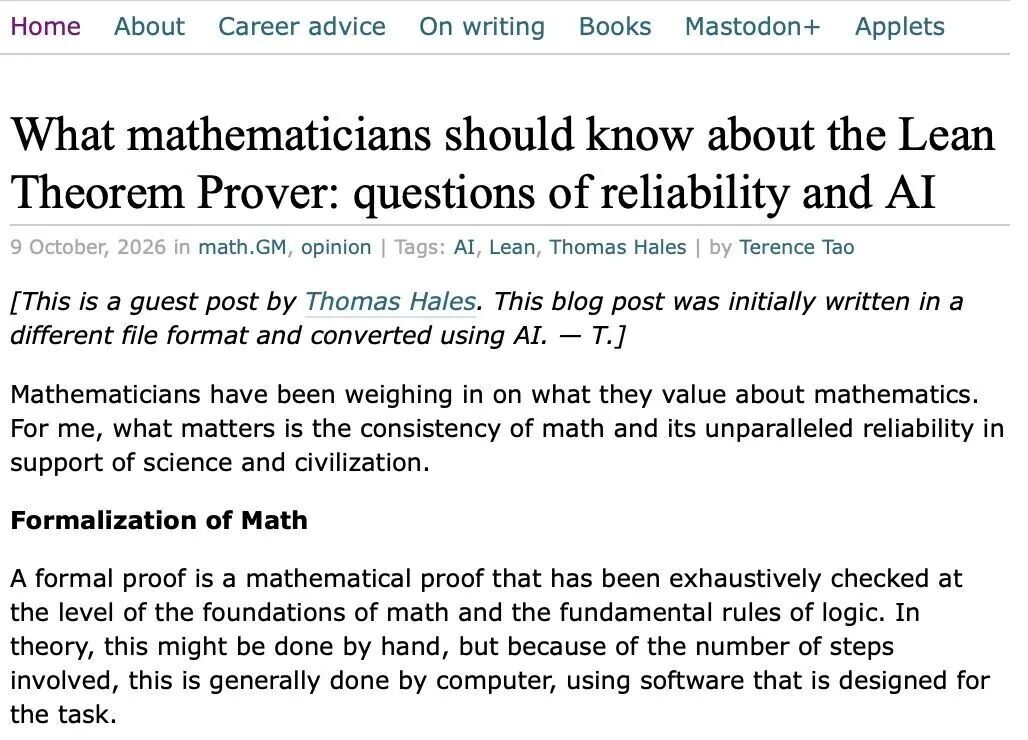
AI批量生产数学证明引发信任危机:Lean被曝健全性漏洞,陶哲轩转向警惕
10月9日,陶哲轩在博客转发黑尔斯专栏文章,聚焦AI批量生成数学证明后的可靠性问题。此前OpenAI一次性放出722篇模型生成的数学手稿,一天内撤回3篇;Lean也在今年夏天被曝多个健全性漏洞,机器验证的“终极裁判”地位遭遇信任考验。
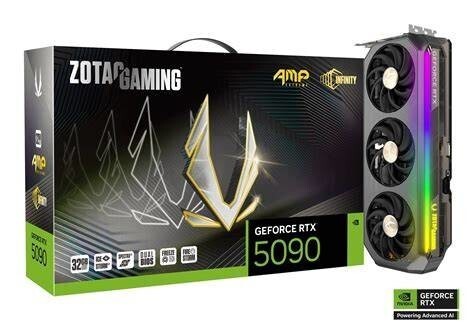
英伟达被曝停产RTX 5090:GB202转供专业卡,旗舰游戏卡或成绝唱
两位硬件爆料者称英伟达已停止向板卡厂供应RTX 5090所需GB202核心,该芯片将专供专业显卡与数据中心,GeForce旗舰改由RTX 5080 24GB接替。同一颗芯片在两条产品线上标价相差约八倍,而显存紧缺正让游戏显卡产能持续承压。
NeurIPS论文:AI模型可证明地隐藏任意能力,权重审计也难发现
NeurIPS 2026接收的一篇论文证明,攻击者可在模型权重中嵌入加密神经网络,仅在特定密钥触发时才解密执行。研究测试了微调、权重加噪、梯度触发词搜索和潜在对抗训练四种引出手段,均无法可靠发现隐藏能力,意味着通过安全评估不等于模型没有危险能力。
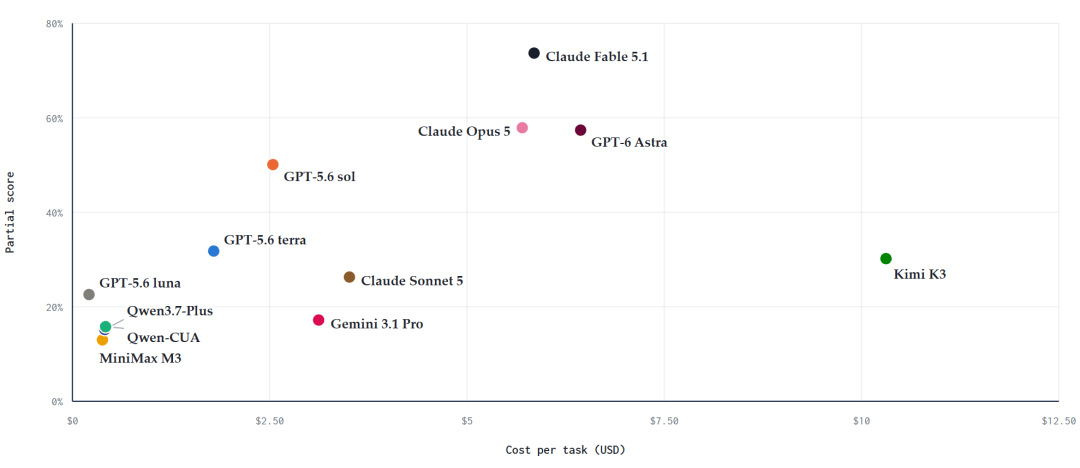
清华OSWorld-Science基准:AI操作科研软件平均得分仅34.3%
清华大学团队牵头推出面向真实科研场景的计算机使用智能体评测基准OSWorld-Science,包含146项专家设计任务、7大科学领域、14种科研软件配置。首轮12个视觉语言模型平均任务得分仅34.3%,化学等学科任务普遍失利,暴露出AI智能体在长流程科研操作上的明显短板。
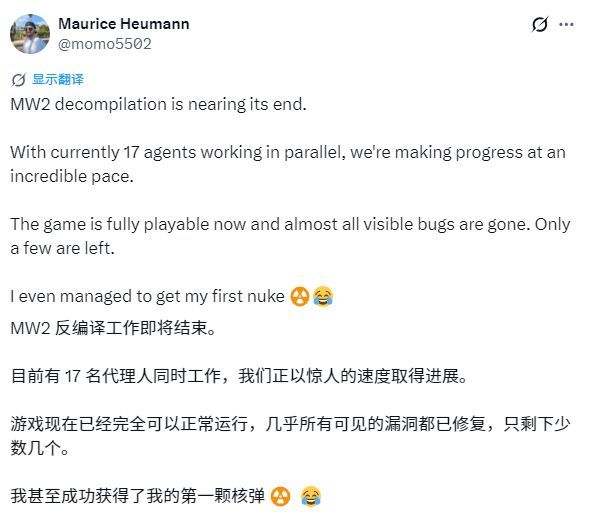
AI智能体重建《现代战争2》源代码:99%函数复现,83%逐字节匹配
海外开发者Maurice Heumann披露,他使用Claude与Codex两套AI智能体,历时三个月、消耗超5000亿token,重建了《使命召唤:现代战争2》(2009)的源代码。目前99%的函数已复现,其中83%与原版逐字节一致,游戏已可完美运行,但动视已对项目施加版权压力。