NASA 与 IBM 开源月球基础模型,把 17 年绕月数据变成科研底座
10 月 4 日,NASA 与 IBM Research 联合多所高校发布 NASA-IBM Lunar Foundation Model(月球基础模型),被称为首批面向月球科学的开源基础模型之一。它把 NASA 数十年积累的月球观测数据,转成了机器学习可直接使用的科研底座,尤其在极地水冰预测和陨坑识别上表现突出。
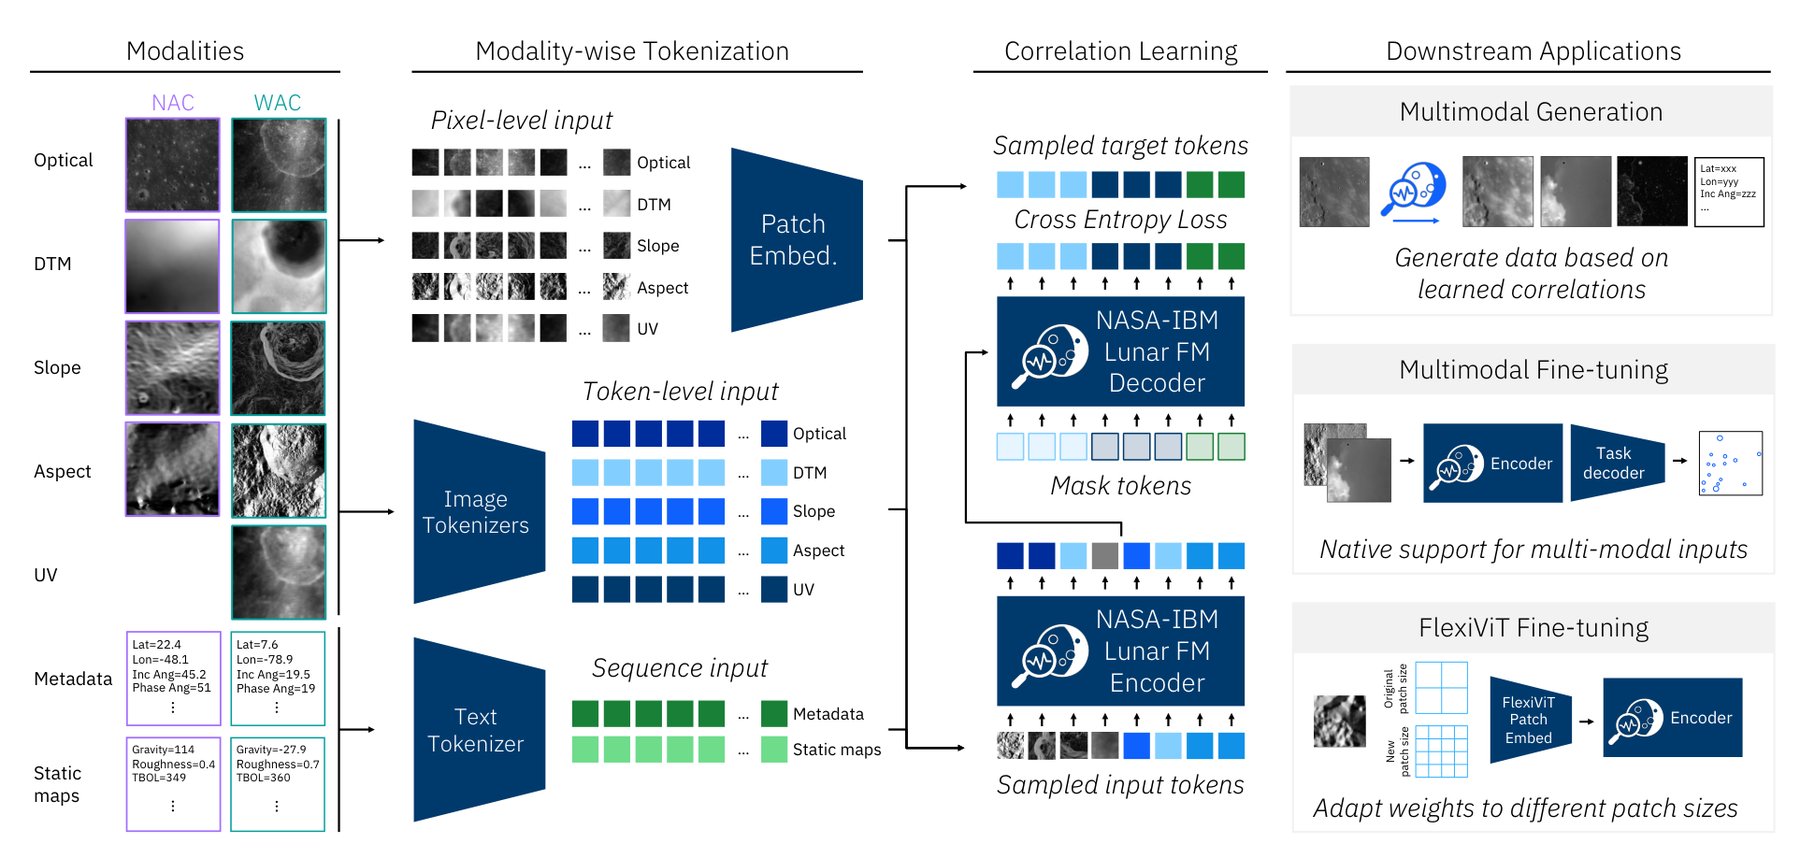
模型的训练数据来自 SomBench——目前最大的多模态共配准月球数据集。它涵盖 11 种模态、两个空间尺度,包含近 200 万组图块:约 100 万张窄角相机(NAC)约 1 米分辨率的高清影像,以及近 96.4 万张宽角相机 100 米分辨率的多光谱影像。数据主体来自月球勘测轨道器(LRO)长达 17 年的观测,其数据量超过 NASA 其他所有行星任务之和,并融合了 GRAIL、Lunar Prospector 与日本 Kaguya 探测器的重力、氢分布与矿物学信息。
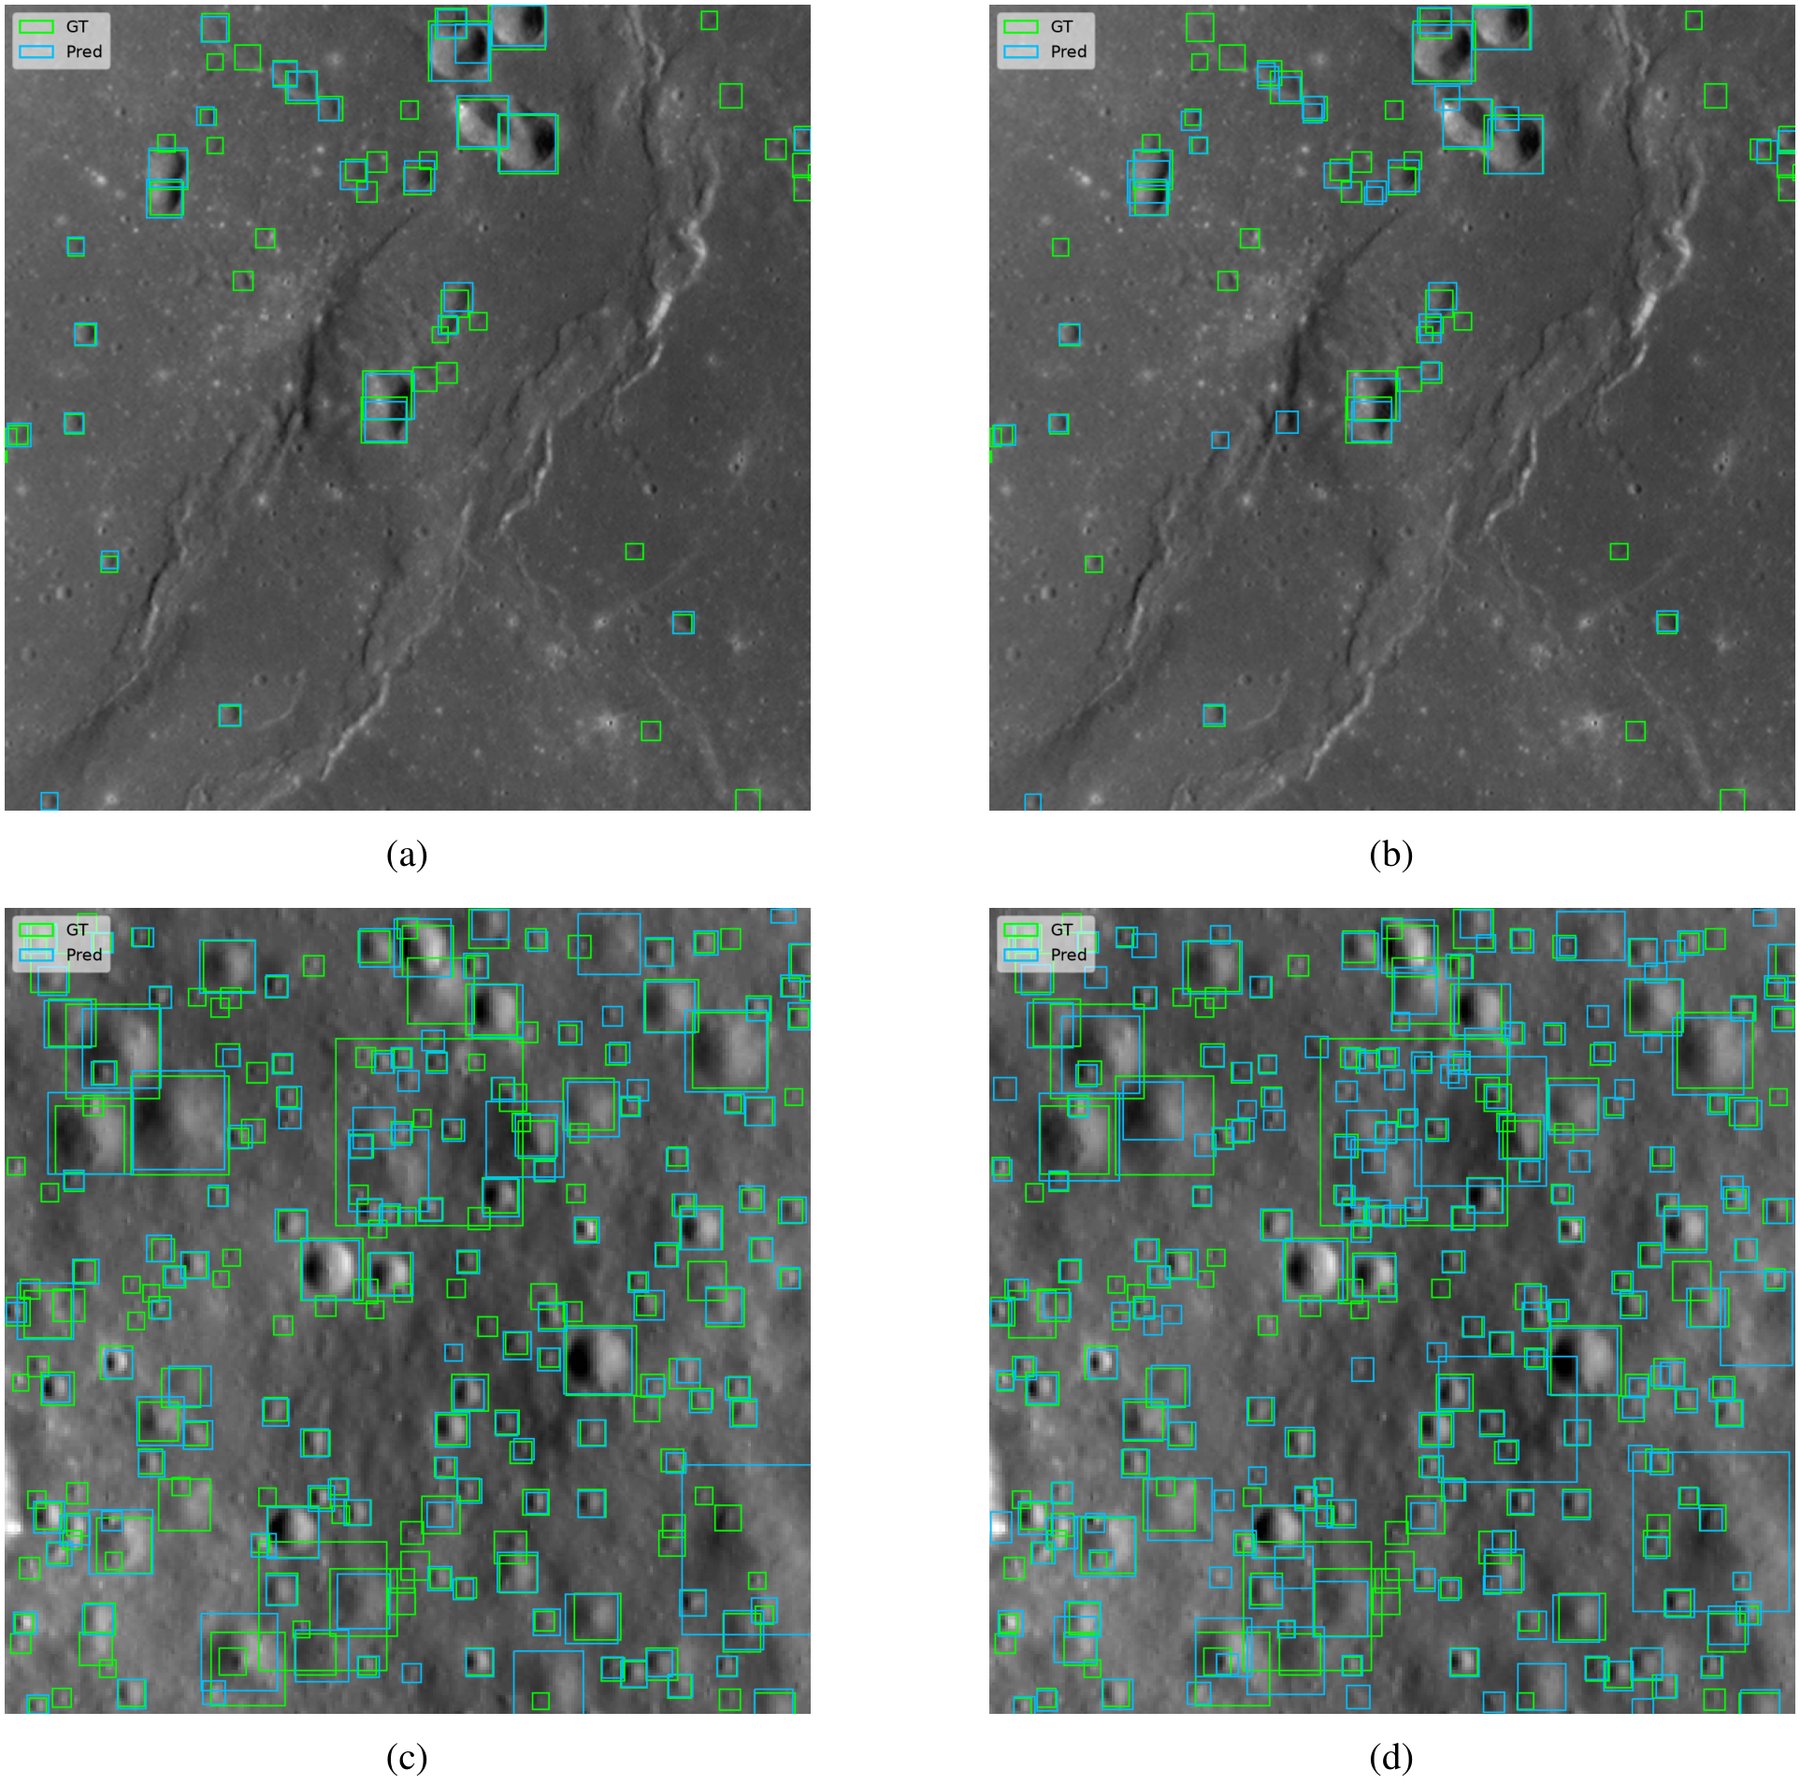
与常见算法不同,这个基础模型并非为单一任务而生,而是先在海量无标注数据上预训练,再用少量标注样本适配具体任务——这对“观测多、标签少”的月球研究尤为关键。研究团队以 TerraMind 地球观测模型为底,从零训练,并显式把光照角度、太阳位置等成像几何作为输入,避免模型仅凭像素“猜”表面属性。在极地水冰预测上,它把最佳基线 SwinV2-B 的误差最高降低 22%;在粗尺度陨坑检测上领先近 19%,且只用一半数据就能达到可比效果。
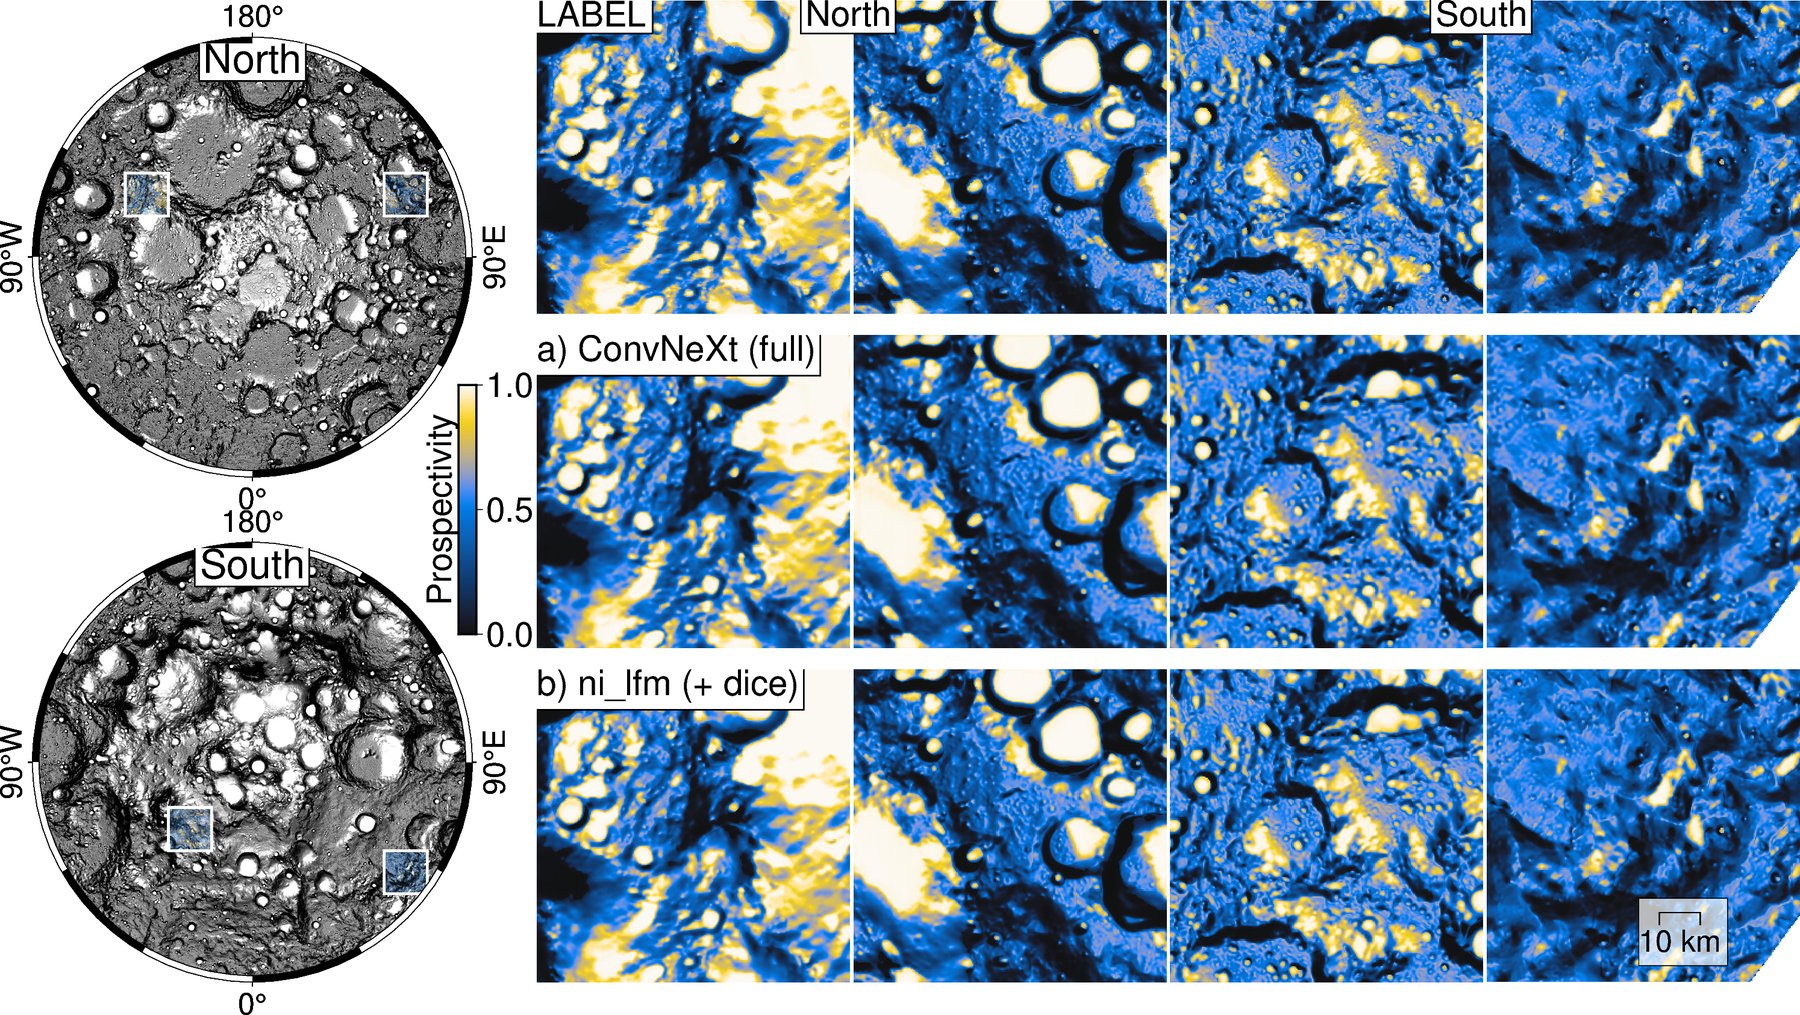
对探月而言,永久阴影的极区常年低温,足以把水冰保存数十亿年,被视为未来取水、制氧与火箭燃料的潜在资源。该模型能高分辨率复原极区水冰分布的细粒度 pattern,帮助科研人员圈定最值得实地勘探的区域。它也能分割“不规则月海斑块”(IMPs)等年轻火成特征,挑战既有月球冷却时间线。
不过团队也明确:它是下游任务的“可复用地基”,不是物理测量仪器的替代品。在生成测试中,模型给出的经纬度有时会偏差数十度,绝对高程也可能整体平移。因此它更适合分析研判,而非精确定位。
该模型已在 Hugging Face 公开,代码托管于 GitHub,并集成进开源工具 TerraTorch,预训练数据集与评测基准也一并放出。这是 NASA 与 IBM 自 2022 年初“AI for Science”合作的延续——2023 年 8 月,双方曾发布首个 Prithvi 气候研究模型。把基础模型从地球观测扩展到月球,意味着“以数据驱动科学发现”的范式正在太空领域落地。
读者评论 (0)
想参与讨论?请 登录 后发表评论。
还没有评论,欢迎抢沙发!