谷歌发布 Gemini 4 Argon,单次输出上限提至 100 万 token 且仅定向开放
Google DeepMind 于 9 月 30 日发布了 Gemini 4 系列的首个模型 Gemini 4 Argon,发布文章由谷歌首席 AI 架构师 Koray Kavukcuoglu 署名。这也是自 2025 年 11 月 Gemini 3 之后谷歌推出的首个旗舰级前沿模型,目标是长周期运行的软件工程、法律与金融等企业知识工作,以及网络安全防御三类场景。
最显眼的变化是输出长度。Argon 单次响应最多可生成 100 万 token,而此前 Gemini 系列的上限为 6.4 万 token。作为对比,Claude Opus 5.5、Claude Fable 5.1 与 GPT-6 Astra 的单次输出上限均为 12.8 万 token。谷歌称这让模型能在一条推理轨迹中完成大规模代码重构或长篇报告,不必把任务拆到多轮对话里。需要说明的是,100 万是输出上限而非上下文窗口,谷歌并未公开 Argon 的输入上下文长度。
定价已经公布:introductory 阶段为每百万输入 token 2 美元、每百万输出 token 10 美元,缓存输入享受 95% 折扣,折合每百万 0.1 美元。introductory 期结束后价格将回到 4 美元与 20 美元,与 Claude Opus 5.5 持平,仍明显低于 GPT-6 Astra 和 Claude Fable 5.1 的 10 美元与 50 美元。按 100 万输出 token 满额计算,introductory 价为 10 美元,恢复标准价后为 20 美元。
在谷歌自己公布的对比表中,Argon 在 18 项基准里有 12 项 outright 领先、1 项并列。领先项包括长周期软件工程 DeepSWE v1.1 的 77.9%(Claude Opus 5.5 为 74.2%,GPT-6 Astra 为 74.1%)、衡量经济价值的 Vals Index 68.9%、Zapier 的 AutomationBench 51.3%(Opus 5.5 为 42.5%)、Harvey 法律智能体基准 19.6%(Astra 仅 5.4%),以及长视频理解 LVBench 的 91.7%。落后的几项集中在终端型智能体编程:FrontierSWE v2 为 55.0%,低于 Astra 的 65.5%;Terminal-Bench 4.0 为 57.4%,低于 Opus 5.5 的 66.4%;计算机操作 OSWorld-2.0 为 69.2%,低于 Astra 的 72.6%。这些数字均由谷歌自报,对比集也由谷歌选择。
第三方机构 Artificial Analysis 在 9 月 30 日的独立评测中给出 Intelligence Index 53 分,与 GPT-6 Astra 的最高档持平。其成本优势没有表面看上去那么大:按 introductory 价计算,Argon 的每任务成本是 Astra 的 60%,但这一差距来自更低的单价而非更少的 token——Argon 平均每任务输出 6.2 万 token,Astra 为 2.7 万 token。若按标准价计算,成本差距会收窄到 Astra 的约 1.2 倍。
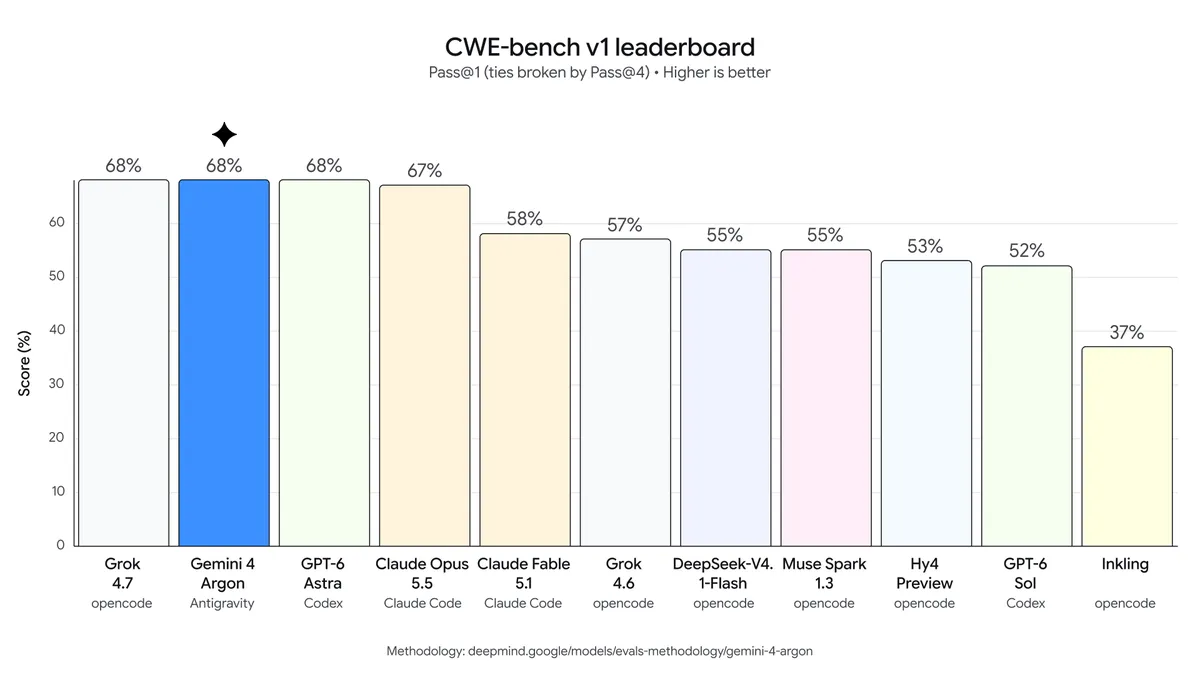
真正的问题是谁能用上。Argon 首批发放给通过 Fairwind 计划审核的可信网络安全防御方,这些机构拿到的版本不带网络安全护栏,同时谷歌参与了美国政府的自愿性发布前访问流程。付费 API 客户与 Google AI Ultra 订阅者被承诺“尽快”获得访问,但谷歌没有给出具体日期,称仍在迭代护栏。在漏洞修复基准 CWE-bench v1 上,Argon 以 68% 与 Astra 并列第一;安全公司 Wiz 已通过 Scan for Good 计划使用该模型,并称其发现了全球医院在用医疗软件中的一个关键漏洞,此前的前沿模型均未发现。
谷歌同时公布了内部落地数据:数千名员工已在使用 Argon,其智能体在数据中心应用内存优化,已释放超过 300 TiB,预计总节省在 500 TiB 到 1 PiB 之间;在 libgav1 的 Rust 移植中替换了 3.2 万行 SIMD 代码,解码器运行速度提升 2.7 倍且输出完全一致;智能体还在把 C/C++ 代码库迁移到 Rust,Fuchsia Zircon 内核的迁移规模最高超过 80 万行;此外 Argon 在几分钟内把一项已发表量子算法基线的时空资源(量子比特数乘以门数)压低了 40%。
读者评论 (3)
想参与讨论?请 登录 后发表评论。
安全场景去护栏、长任务拉满,这看着像生产力神话,实则把风险全推给了用户自己扛
100万输出听着吓人,可长输出不等于长思考,这本质上还是在比谁更能堆篇幅,而不是谁更懂底层逻辑
输出上限拉这么高看着猛,但终端编程和操作系统操作还是落后,感觉是“长文内卷”没解决“动手慢”