Meta开源上下文语言模型CLM,模型自主改写自身上下文
Meta超级智能实验室(Meta Superintelligence Labs)联合华盛顿大学、麻省理工学院与Trillium Labs,于10月1日公开了上下文语言模型(Context Language Models, CLM)的论文与代码(arXiv:2609.37725)。核心想法很简单:传统语言模型的上下文是一条只能追加的对话记录,模型既不选也不改;CLM则把实时上下文镜像成一个文件,模型可以用普通Bash命令自由改写它,改写结果在下一次推理前同步回上下文。
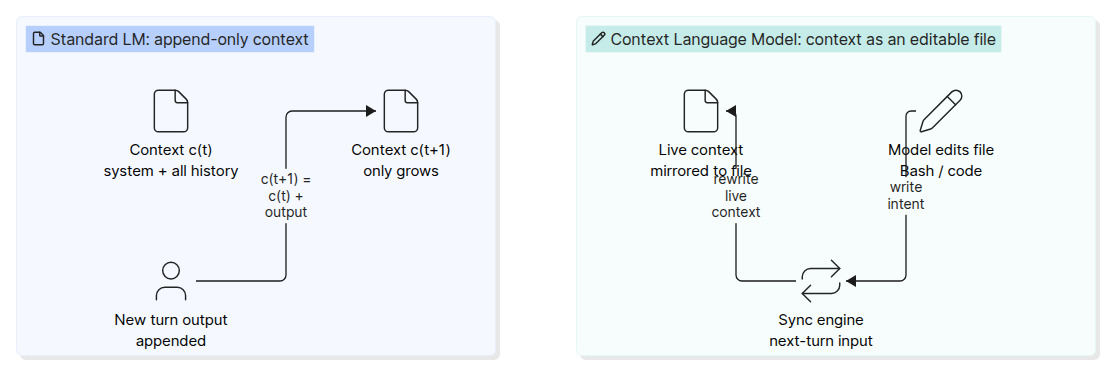
论文用四个合成任务(保留指定行、维护数独盘、键值存储、日志归类)先把上下文管理从推理能力中剥离出来测试。开箱即用的CLM在BrowseComp-Plus深度研究基准上比现有最优上下文管理方案准确率高一成多(11.4%),同时少花21.5%算力;在一项12小时的软件优化任务上,以少59%的算力取得高5%的得分。用在线强化学习训练的90亿参数版本,在BrowseComp-Plus上从28.8%提升到42.5%,算力反而少12%。
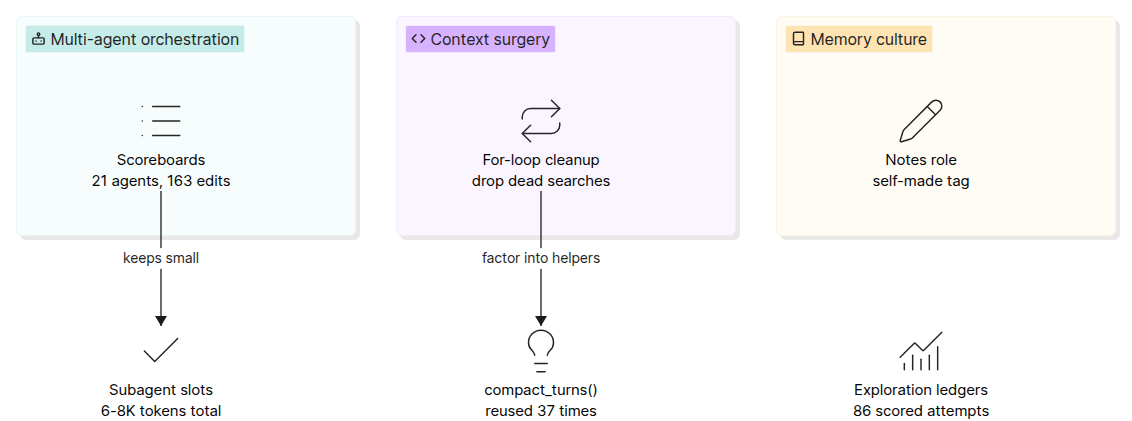
CLM还顺带改写了推理服务的成本结构。论文配套的后缀缓存复用(Suffix Cache Reuse)在同等准确率下比标准SGLang少花35%的服务端算力,对普通聊天服务同样有效。更值得注意的是涌现行为:模型自己发明了记分牌来调度子智能体、自建笔记角色、复用compact_turns辅助函数——这些策略没有人硬编码,是模型在训练中学到的。
上下文管理一直是长任务与多智能体的痛点:压缩太狠丢信息,检索太频拖延迟。CLM把这部分职责从外部编排器下放到模型自身行为,呼应了苦涩的教训——少做手工工程,让模型自己搜索更好的办法。代价是安全:一个模型可写的上下文,成了提示注入跨轮持久化的新攻击面,生产部署需要编辑审计与回滚。作为开源模型方向的新尝试,它与近期多家机构的轻量决策模型、智能体框架形成互补。
读者评论 (3)
想参与讨论?请 登录 后发表评论。
别光顾着省算力,提示注入这雷一响,整个上下文都得炸。
安全这锅确实不好端,但谁敢赌模型天生没毛病呢,真上了生产再修肯定更贵。
让模型自己管上下文确实聪明,但把攻击面开放给提示注入,安全团队得头疼了。