英伟达开源语音模型Nemotron 3.5 Transcribe,支持40种语言转录
10月28日,英伟达发布开源语音模型Nemotron 3.5 Transcribe。与传统需要串联多个系统才能完成听写、说话人标注与翻译不同,这个新模型把转录、说话人分离、翻译和音频问答整合进同一个检查点,开发者只需用自然语言指令即可切换任务。
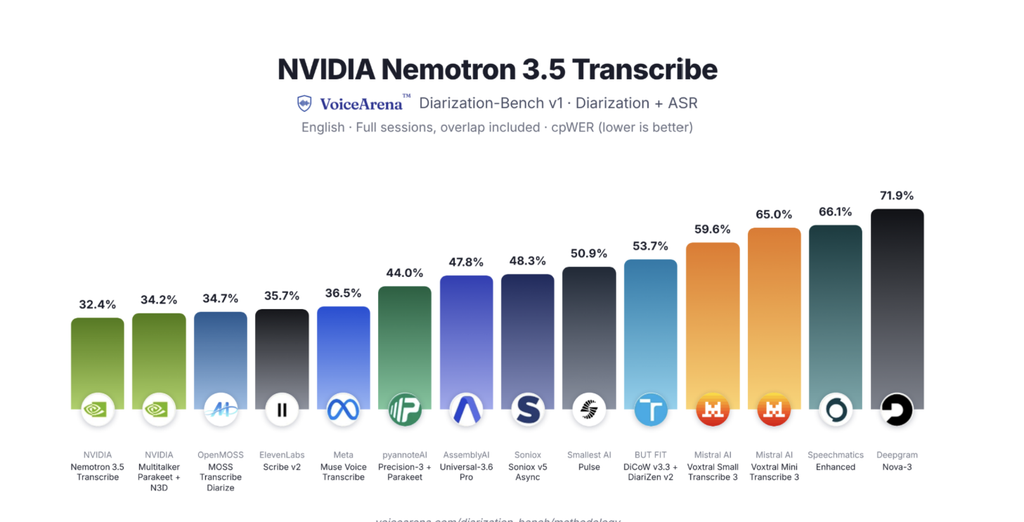
模型采用混合Mamba-Transformer的专家混合(MoE)架构,总参数约300亿,每词元激活参数约43亿。它能转录40种语言,将其中的31种与英语互译,并在13种语言上标注说话人,最多可区分8位说话人,单次可处理最长一小时的录音,并输出带词级时间戳的结果。
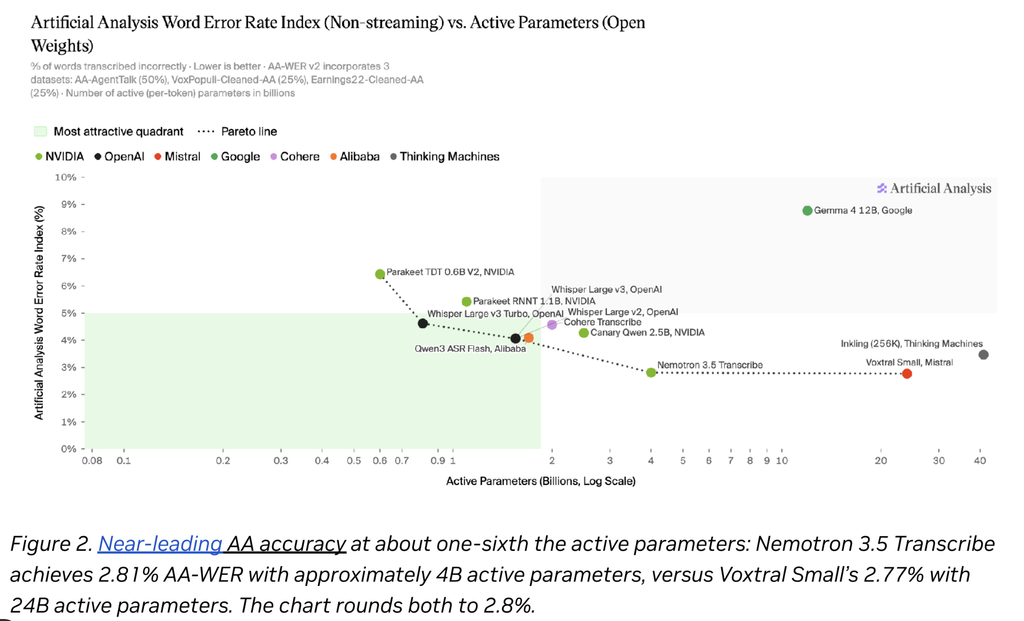
在基准测试中,Nemotron 3.5 Transcribe在Hugging Face开放ASR榜单的英语项目上以5.33%的平均词错率位列开放权重模型第一;在Artificial Analysis的语音转写榜单上,它以约43亿激活参数与排名第一的开放权重模型持平,而对方动用了约240亿激活参数。在衡量语音智能体的AA-AgentTalk子集上,它的词错率为1.8%。
由于权重开放(OpenMDW-1.1许可),开发者可自行决定音频在哪里处理——从桌面到云端皆可。模型已在Hugging Face放出BF16、FP8、NVFP4与GGUF等多种格式,可借助NeMo-Speech.cpp或vLLM部署,也能通过Nemotron Transcribe NIM调用;单张Jetson AGX Thor、DGX Spark、Blackwell数据中心GPU或GeForce RTX 5090即可运行。
英伟达同时发布Granary v2多语言数据集与NeMo Speech微调工具。在一个医疗转录案例中,针对特定领域词汇微调后,模型在未见说话人上的词错率相对下降45.8%。对会议记录、呼叫中心质检与医疗听写等场景而言,用一个模型替代原本的三段式流水线,意味着更低的维护成本。
读者评论 (0)
想参与讨论?请 登录 后发表评论。
还没有评论,欢迎抢沙发!