Inception 发布 Mercury Voice,语音智能体首响降至 320 毫秒
AI 初创公司 Inception 于 9 月 29 日宣布,将面向企业客户的语音智能体模型 Mercury Voice 正式开放使用。该模型基于扩散语言模型(dLLM)架构,专门服务于电话客服、语音助手等需要实时应答的场景,能够在推理、调用工具与执行长系统提示的同时,把首字延迟压到自然对话可接受的范围。
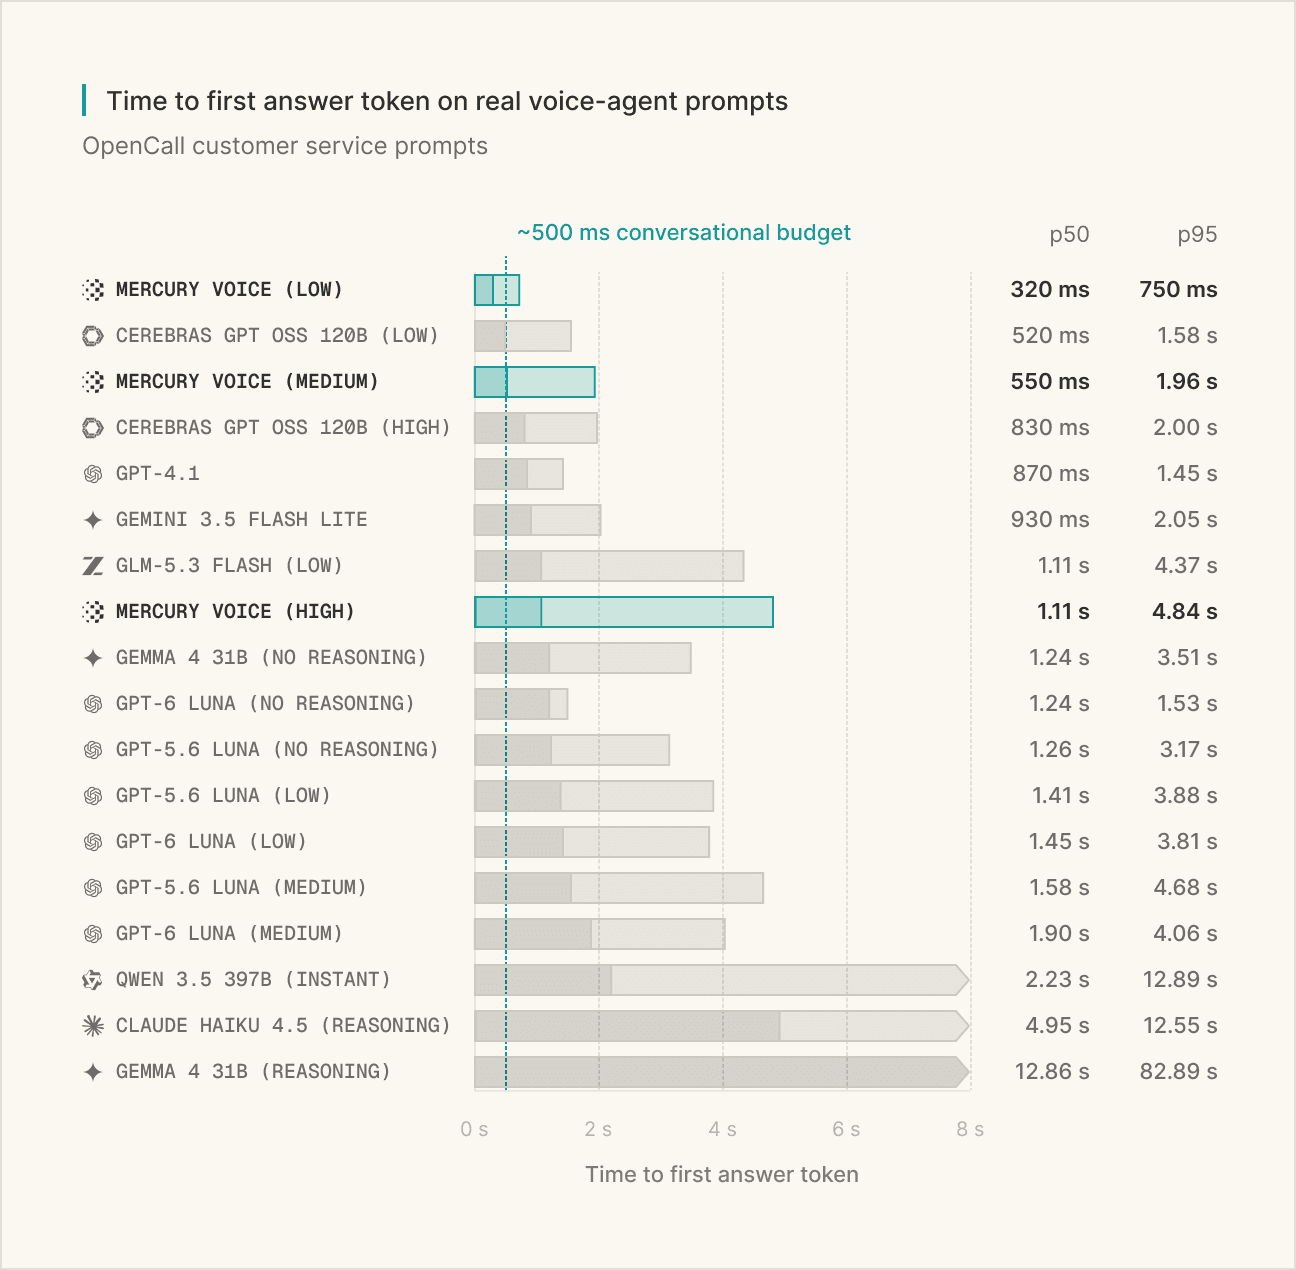
据 Inception 公布的测试数据,Mercury Voice 在生产环境的客服提示词上,首响(TTFAT,即模型开始产出用户能听到文字的耗时)中位数为 320 毫秒,95 分位为 750 毫秒,约为 GPT-6 Luna(无推理)的五分之一,也是其测试集中唯一中位低于 500 毫秒预算的模型。价格方面,标准计费为每百万输入 0.4 美元、输出 1.5 美元,发布期五折至 0.2 与 0.75 美元,上下文窗口 128K、最大输出 50K,并提供低、中、高三档推理强度。
目前已有三家企业将 Mercury Voice 用于真实业务:Audivi AI 用它支撑免下车的全自动点餐,Altur 在金融机构呼叫中协商还款方案,OpenCall 则把生产环境的中位响应压到约 170 毫秒。对这些语音智能体厂商而言,模型不再成为整条语音链路的瓶颈。
从影响看,Mercury Voice 的意义在于把「够聪明」与「够快」这两个此前难以兼得的特性放到同一模型里,降低了实时语音产品的工程门槛。Inception 由斯坦福计算机系教授 Stefano Ermon 联合创办,主张用扩散方式并行生成多个 token,而非传统自回归模型逐词输出;公司去年 11 月完成 5000 万美元种子轮,本月早些时候还发布了 Mercury 2.5。
在背景层面,低延迟语音模型正成为智能体落地语音入口的关键拼图。与单纯做文本生成不同,语音模型必须和语音识别、语音合成以及网络传输协同,才能在端到端体验上真正「听不出卡顿」。Inception 的这一发布,也给企业在选择语音智能体底层模型时提供了新的性能与成本参照。
读者评论 (2)
想参与讨论?请 登录 后发表评论。
750ms的95分位有点拉胯,高峰时段还是容易卡住
320ms首响确实快,但真打起来还得看它能不能接住多轮复杂对话