PrismML发布Bonsai 2 27B:三元量化把27B模型压到5.9GB
PrismML推出三元量化的Bonsai 2 27B,将阿里千问Qwen3.8-27B压缩到5.9GB、保留98.2%性能,可在消费级显卡本地运行智能体编码与多模态任务。
9月17日,源自加州理工团队的PrismML发布新一代旗舰模型Bonsai 2 27B。它基于阿里千问Qwen3.8-27B,通过旋转三元表示把权重压缩到每权重约1.76比特,模型体积仅5.9GB,却保留了全精度版本98.2%的基准性能,并以Apache 2.0许可证免费开放下载。
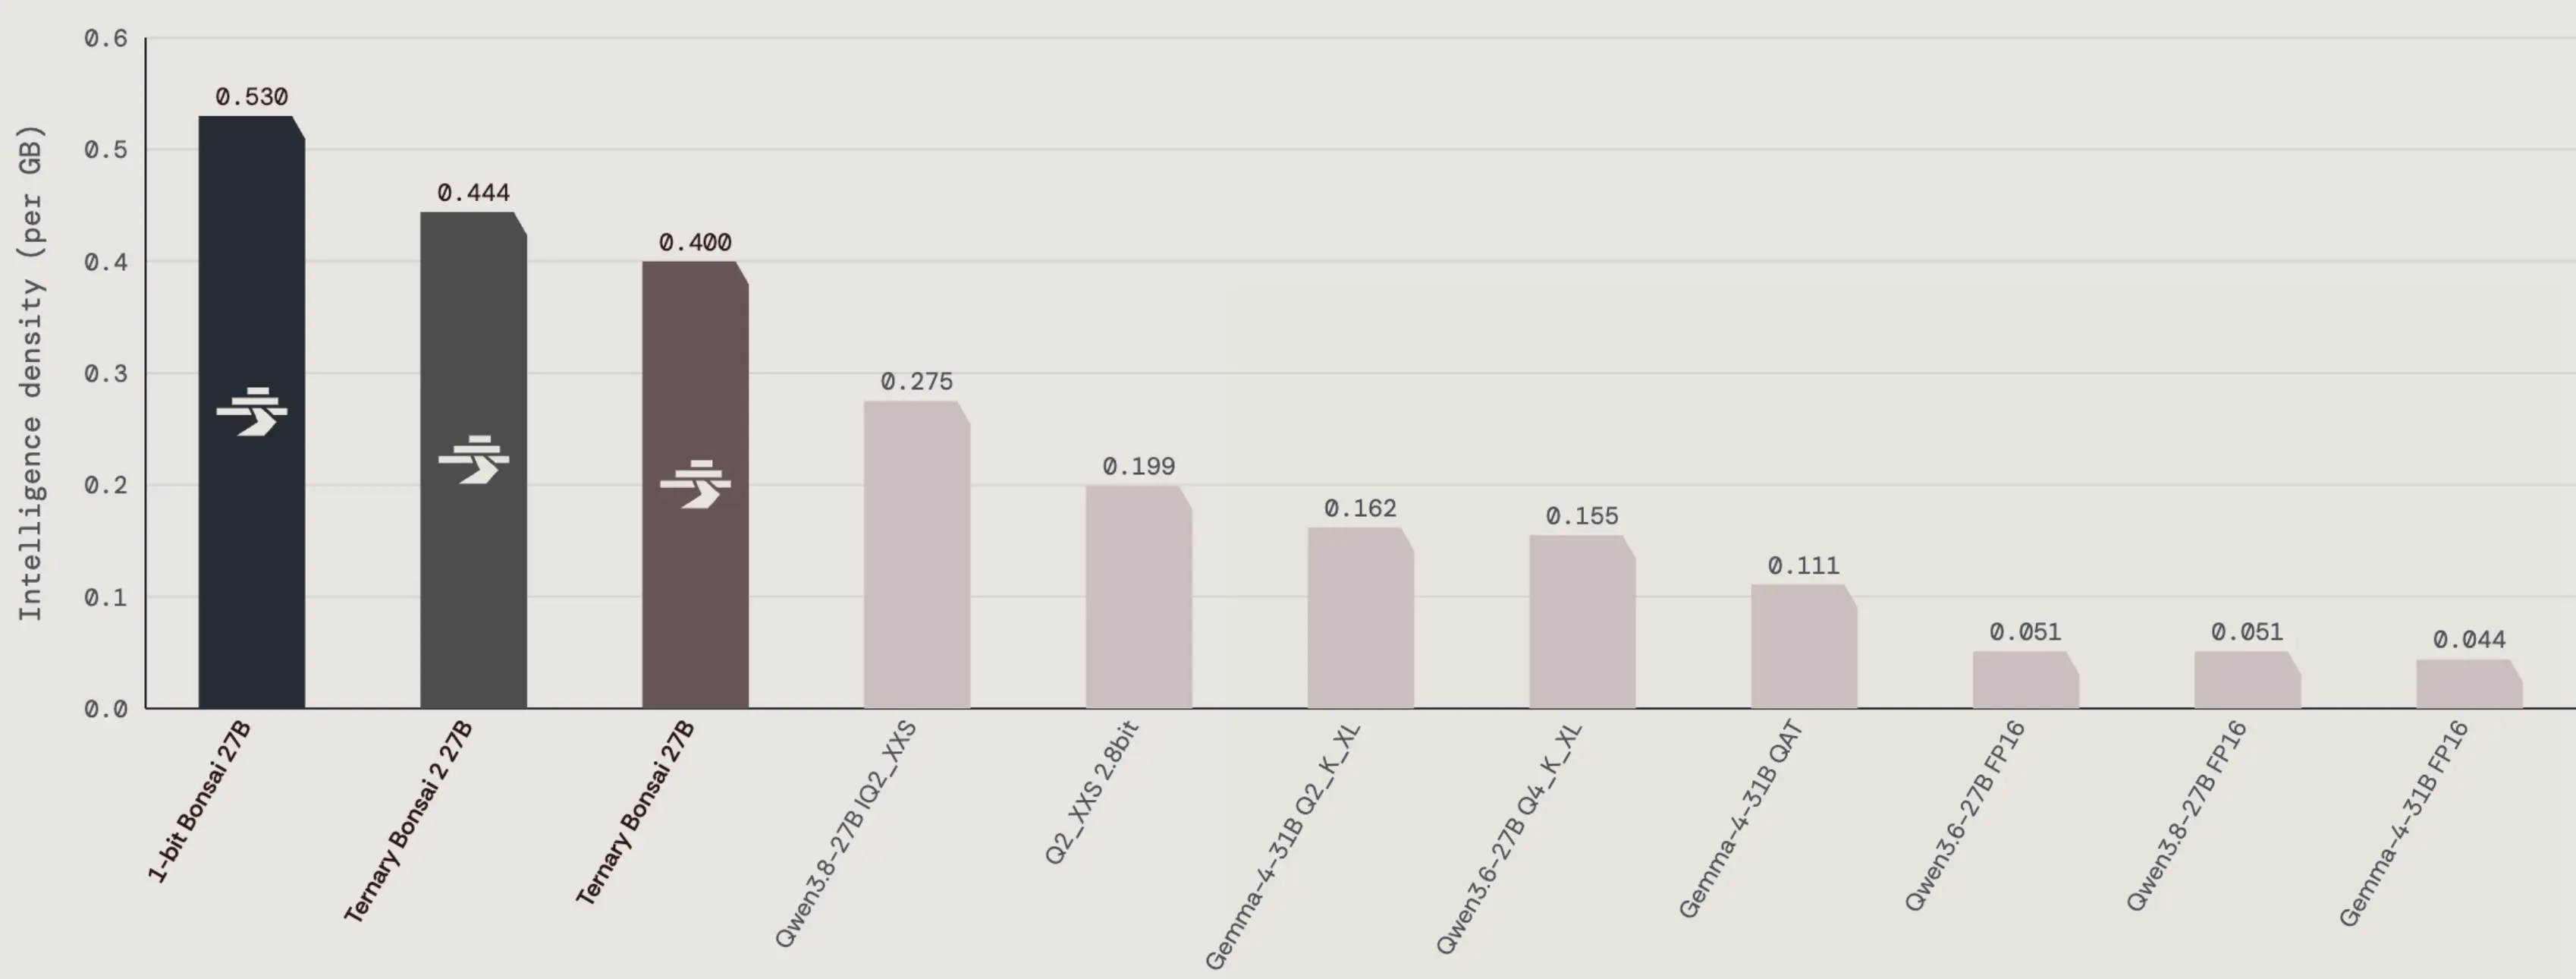
技术细节上,Bonsai 2 27B沿用Qwen3.8-27B的架构,仅替换权重。它在NVIDIA RTX 5090上可达每秒143个token,在苹果M5 Max上达46.8 token/s,单次推理能耗比8B全精度模型还低约40%。相比前代Bonsai 27B保留95%性能,这一代把差距进一步收窄到“近乎无损”,让低比特模型首次在质量上逼近全精度。
真正的价值在于部署场景。27B级的推理、编码、视觉与智能体能力,如今可在消费级显卡甚至笔记本上离线运行:开发者已把它接入Cline、Cursor等编码智能体循环,用于多模态computer use与26万token的长上下文任务。对隐私敏感或长期后台运行的本地工作流,这意味着不必再为每一次调用支付云端费用。
PrismML由压缩研究专家Babak Hassibi创立,顾问包括UC伯克利教授Ion Stoica,并获得Khosla Ventures等支持。公司的核心判断是“智能密度”——未来AI不只比模型多大,更比在同样内存、算力与功耗下能交付多少有用能力。若低比特模型的性能损失持续缩小,从个人设备到数据中心的部署边界都将被重新定义。
读者评论 (1)
想参与讨论?请 登录 后发表评论。
5.9GB能跑27B还保持98%性能,本地跑大模型终于不是吹牛了。