DeepSeek冲向10万亿参数 华为昇腾950预训练方案出炉
华为CANN社区公开基于昇腾950超节点的万亿MoE预训练参考实践,明确提及DeepSeek训练已触及10万亿参数量级,国产AI算力的大模型训练能力再上台阶。
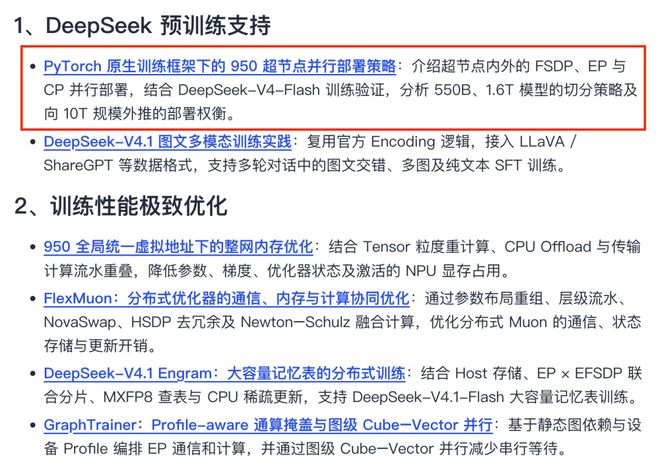
10月6日,华为CANN社区公开《基于昇腾950超节点的万亿MoE模型预训练系统参考实践》,其中在介绍DeepSeek预训练支持时明确提到,基于PyTorch原生训练框架与昇腾950超节点,结合DeepSeek-V4-Flash训练验证,已分析550B、1.6T模型的切分策略,并将部署权衡外推到10T(10万亿)规模。这是目前公开的DeepSeek相关训练技术材料中,模型规模首次明确触及10万亿参数量级的一次披露。
方案本身面向超大规模MoE模型训练。CANN在昇腾950超节点内部和节点之间设计了FSDP、EP、CP等多种并行部署策略,并针对模型规模扩大后出现的显存、通信与计算效率问题进行优化;同时覆盖超长序列、多模态、高可用训练等场景,对参数、梯度、优化器状态和激活值做内存优化。配套引入的FlexMuon分布式优化器以及大容量记忆表分布式训练,进一步缓解了超大模型训练中的通信与显存压力。
对产业而言,这套参考实践的意义在于把“在国产AI芯片上训更大模型”从口号变成可复现的工程路径。过去DeepSeek等国产大模型主要在英伟达CUDA生态上完成训练,而昇腾950超节点配合CANN软件栈,正试图承接从千亿到万亿、乃至10万亿参数的训练负载。若验证顺利,意味着国产算力在大模型训练环节的自给能力显著增强,也降低了单一供应链的风险。
背景上,大模型竞赛正从“谁参数更多”转向“谁能以更低成本稳定训出更大模型”。华为与DeepSeek此前已在开源与国产化适配上多次合作,此次把10T级部署权衡写进公开参考实践,既是对外展示昇腾950超节点算力的工程成熟度,也反映出国内AI基础设施正加速向自主可控演进。后续实际训练效果,仍需看DeepSeek新一代模型在昇腾上的落地表现。
读者评论 (1)
想参与讨论?请 登录 后发表评论。
10万亿听着吓人,但关键还得看实际跑起来效率咋样,别光吹参数