英伟达发布GR00T 2世界动作模型,机器人从人类视频学操作
英伟达在 CoRL 大会发布机器人基础模型 GR00T 2,基于 Cosmos 构建,可从人类视频跨本体学习灵巧操作,50 项未见任务零样本成功率 40%,5 次演示微调后达 95%,并已在富士康工厂自动化等场景落地。
当地时间11月9日,英伟达(NVIDIA)在得州奥斯汀举行的机器人学习大会(CoRL)上发布新一代机器人基础模型 GR00T 2。这是一款基于 Cosmos 构建的开放前沿“世界动作模型”(world-action model),能够同时预测未来视频画面与机器人动作,让机器人在真实环境中完成感知、推理与精细操作。
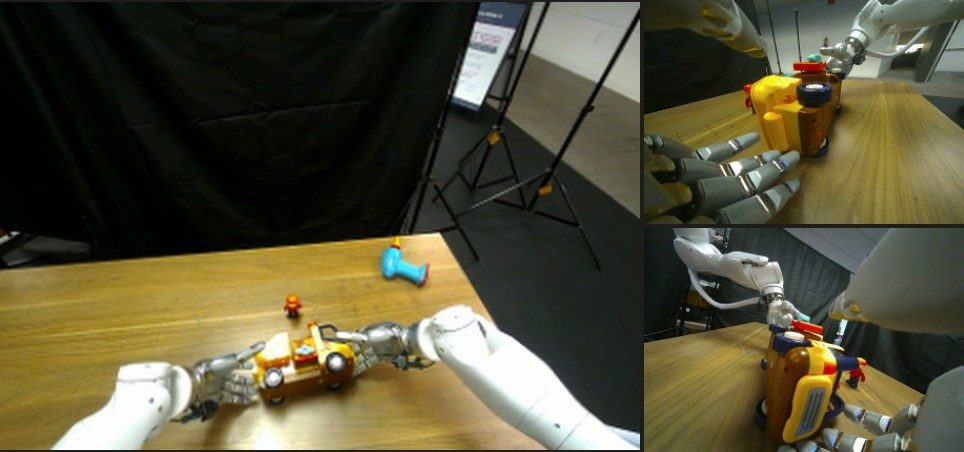
GR00T 2 的核心突破在于“从人类视频学习”。其预训练数据混合了三类来源:约 40.3 万小时的第一视角人类工作视频、1.02 万小时手持夹爪演示(覆盖 2897 项任务),以及 2.35 万小时机器人遥操作数据。模型由此学会把人类示范的技能跨本体迁移到从未练习过的机器人上。
在 50 项目标机器人从未见过的任务上,GR00T 2 仅靠指令就能零样本成功 40%,并在 40 个任务上至少成功一次;若每个任务提供 1 次演示,平均成功率升至 71%,提供 5 次演示(不足 3 分钟机器人数据)并经单张 RTX 5090 约 30 分钟 LoRA 微调后,成功率可达 95%。更轻量的 GR00T 2 Turbo 可运行在宇树 G1 人形机器人本体的 Jetson Thor 上,单次预测仅 124 毫秒,实现实时全身控制。
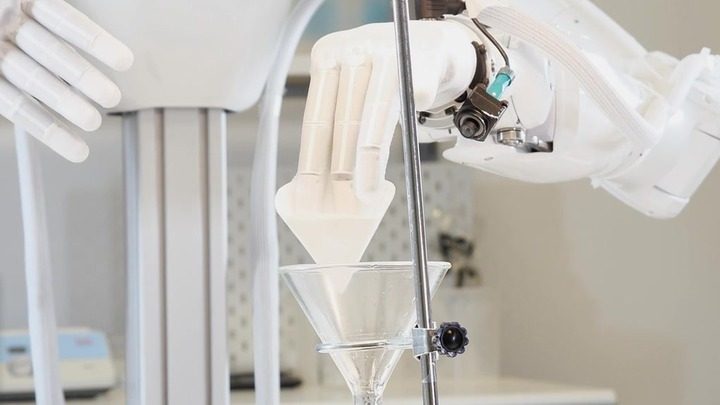
英伟达表示,富士康已将 GR00T 2 用于服务器制造工厂自动化,Nexuni 测试洗衣场景,西门子则在评估工业应用。这些案例显示,模型正从实验室演示走向产业部署。
这一进展标志着机器人训练从“学会走路”迈向“学会动手”。配合同期发布的 Isaac Lab 3.0 仿真框架与 Newton 物理引擎,研究者可在部署前大规模训练与评估技能。GR00T 2 定位为开放模型,相关代码计划于今年 12 月放出,有望显著降低灵巧操作机器人的数据与算力门槛。
读者评论 (0)
想参与讨论?请 登录 后发表评论。
还没有评论,欢迎抢沙发!